5 ข้อผิดพลาด Spark ที่พบบ่อย
เคยไหมครับที่ Spark job รันผ่านแล้วแต่ช้าจนต้องนั่งรอเป็นชั่วโมง หรือไม่ก็ขึ้น OutOfMemory กลางทางแบบไม่มีสาเหตุที่ชัดเจน
เรื่องนี้ผมว่าเกือบทุกคนที่ทำ Data Engineering ด้วย Spark น่าจะเคยเจอ ซึ่งส่วนใหญ่ปัญหาไม่ได้อยู่ที่ขนาดของ Cluster แต่อยู่ที่วิธีที่เราเขียนโค้ดเอง และสิ่งที่ช่วยให้เห็นปัญหาได้เร็วที่สุดก็คือ DAG ใน Spark UI นี่แหละครับ
บทความนี้เลยจะลองรวม 5 ความผิดพลาดที่ Data Engineer มักเจอบ่อยที่สุด
ก่อนจะเริ่ม อ่าน DAG ยังไงให้ไม่งง
ใน Spark UI เราจะดู DAG ได้สองที่หลักๆ ครับ
- แท็บ SQL / DataFrame จะเห็น Query plan เป็นกล่องๆ ต่อกัน มี Exchange (คือ Shuffle) คั่นอยู่ระหว่างกล่อง ดูภาพรวมได้ง่ายที่สุด
- แท็บ Stages กดเข้าไปในแต่ละ Stage จะเห็น DAG Visualization ระดับ Stage ซึ่งเอาไว้ดูว่ามี Task อะไรบ้าง และมี Metrics ของแต่ละ Task
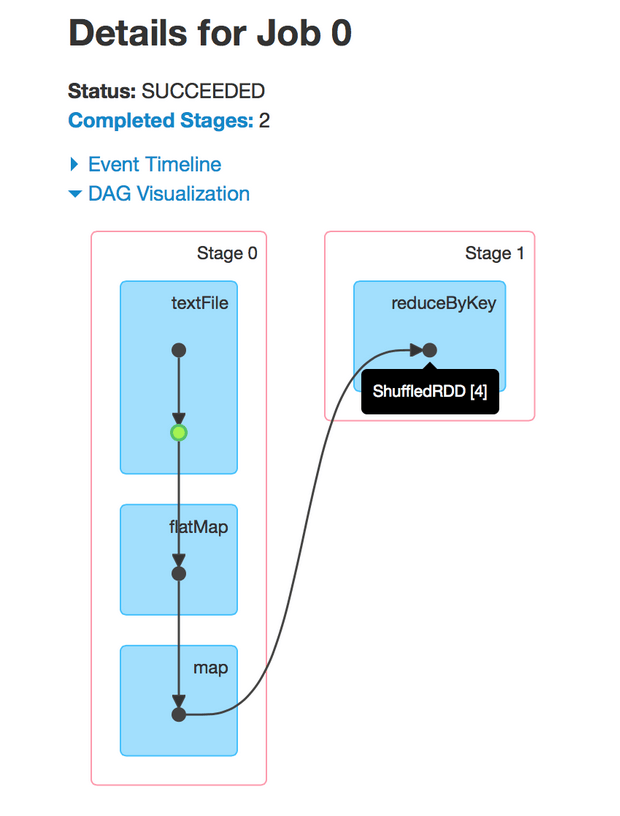
จำง่ายๆ ว่า ทุกครั้งที่เห็น Exchange ก็คือมี Shuffle เกิดขึ้น และ Shuffle ถือเป็น Operation ที่กิน Resource และเสียเวลามากที่สุดตัวหนึ่งใน Spark เลยครับ เพราะต้องเขียน Disk, ส่งผ่าน Network แล้วอ่านกลับมาใหม่
ข้อที่ 1: Cache ทุกอย่างที่เห็น
เกิดอะไรขึ้น
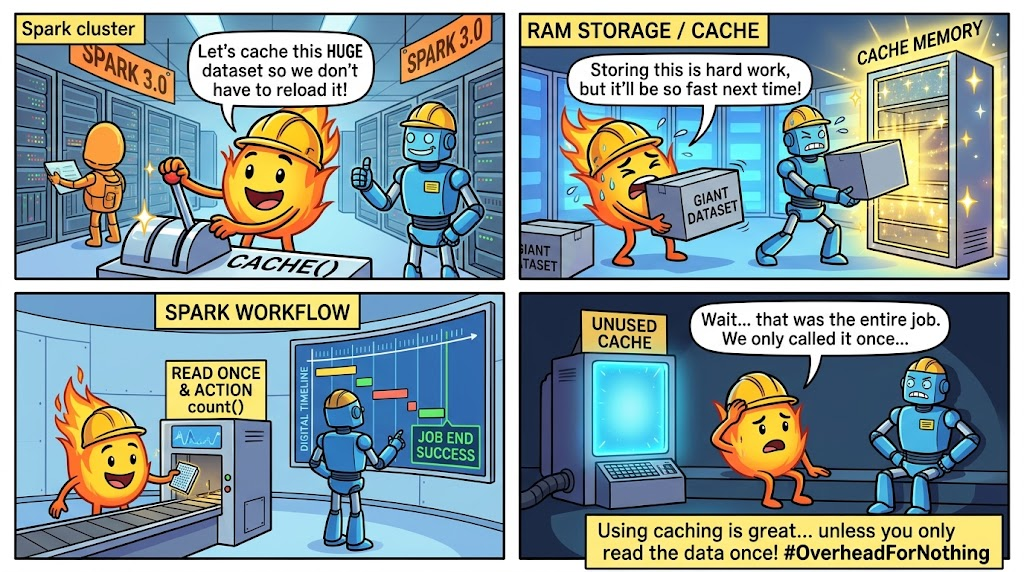
พอได้ยินว่า cache ช่วยให้เร็วขึ้น หลายคนก็เลยใส่ .cache() หรือ .persist() ให้ทุก DataFrame ที่ผ่านมือ ผลคือ Memory ของ Executor เต็มไปด้วยข้อมูลที่ใช้แค่ครั้งเดียว ข้อมูลที่ควร Cache จริงๆ กลับโดนเตะออก (Eviction) หรือล้นไป Disk ซึ่งช้ากว่าคำนวณใหม่เสียอีก
df_raw = spark.read.parquet("s3://bucket/raw/")df_raw.cache() # ใช้ครั้งเดียว ไม่ต้อง cachedf_clean = df_raw.filter("status = 'ok'").cache() # cache อีกแล้วdf_final = df_clean.groupBy("user_id").count().cache() # และอีกdf_final.write.parquet("s3://bucket/out/")
วิธีสังเกต
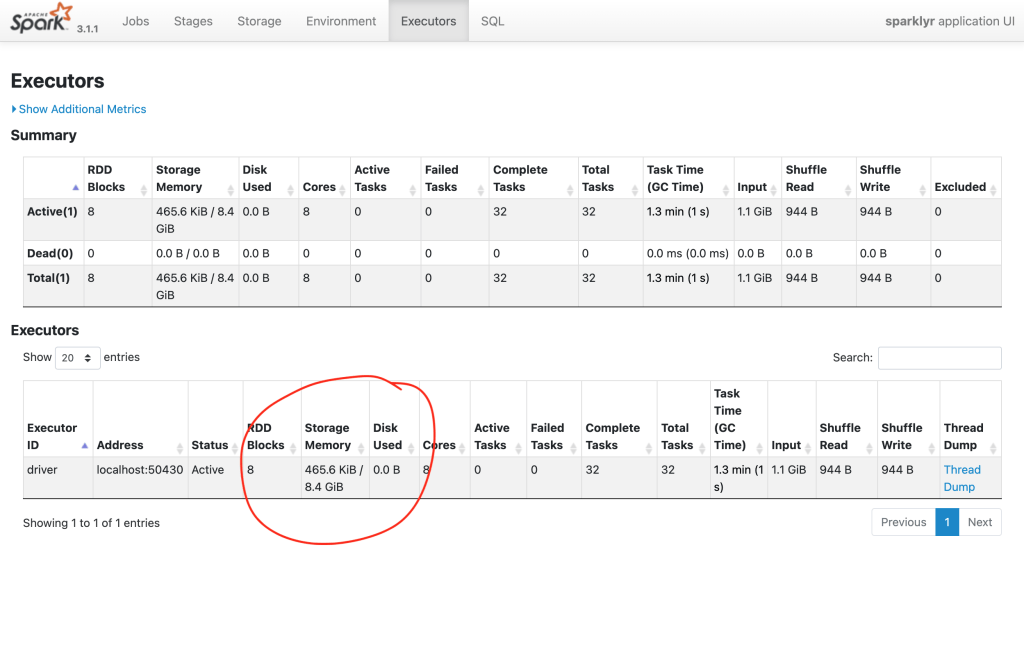
- แท็บ Storage มี RDD/DataFrame ที่ถูก Cache เต็มไปหมด และแต่ละตัวมี Fraction Cached ไม่ถึง 100% หรือมีขนาดใน Disk เยอะ
- ใน DAG เห็นกล่อง
InMemoryTableScanในจุดที่ข้อมูลถูกอ่านแค่ครั้งเดียว - แท็บ Executors เห็น Storage Memory ใกล้เต็ม และ GC Time สูงขึ้นผิดปกติ
วิธีแก้
หลักง่ายๆ ครับ Cache เฉพาะข้อมูลที่ถูกใช้ซ้ำมากกว่าหนึ่ง Action ถ้าใช้ครั้งเดียวไม่ต้อง Cache และเมื่อใช้เสร็จแล้วอย่าลืม unpersist() ด้วย
df_clean = df_raw.filter("status = 'ok'")df_clean.cache() # ใช้ซ้ำสองรอบด้านล่าง เลย cachedaily = df_clean.groupBy("dt").count()by_user = df_clean.groupBy("user_id").count()daily.write.parquet("s3://bucket/out/daily/")by_user.write.parquet("s3://bucket/out/by_user/")df_clean.unpersist()
ถ้าข้อมูลใหญ่กว่า Memory จริงๆ ให้ใช้ persist(StorageLevel.MEMORY_AND_DISK) แทน หรือเขียนผลลัพธ์กลางทางลง Parquet แล้วอ่านกลับมา ซึ่งบางทีก็เร็วและเสถียรกว่า Cache อีกครับ
ข้อที่ 2: จำนวน Partition ไม่เหมาะกับข้อมูล
เกิดอะไรขึ้น
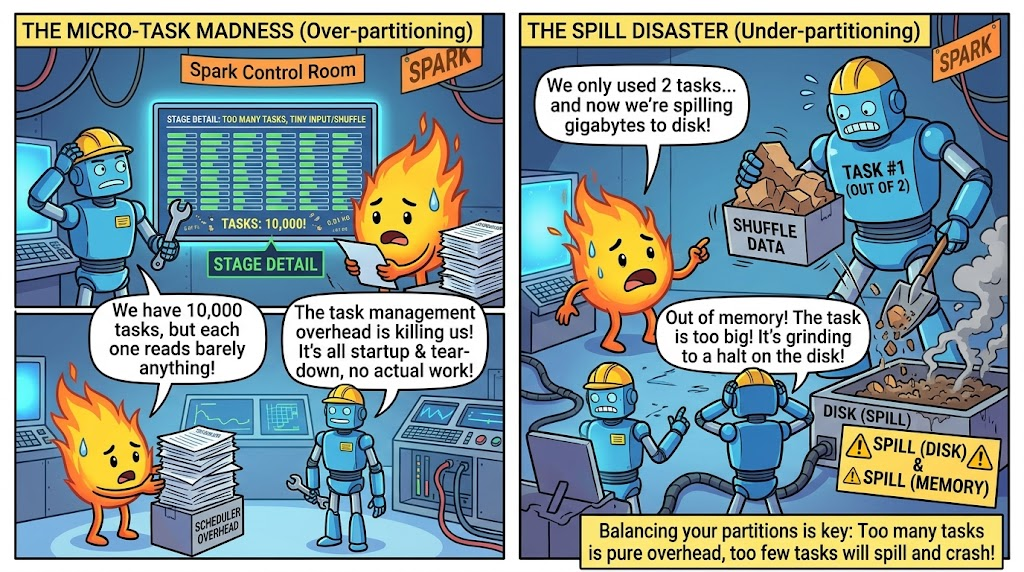
ค่า Default ของ spark.sql.shuffle.partitions คือ 200 ซึ่งเป็นเลขที่ไม่ได้เหมาะกับข้อมูลของใครเลยครับ ถ้าข้อมูลเล็กก็จะได้ Task จิ๋วๆ 200 ตัวที่เสียเวลา Schedule มากกว่าทำงานจริง แต่ถ้าข้อมูลใหญ่ก็จะได้ Partition ใหญ่เกินไปจน Spill ลง Disk หรือ OOM
ถึงแม้ Spark ยุคหลังจะมี AQE ช่วยปรับขนาดให้อัตโนมัติ แต่ถ้าเข้าใจพื้นฐานตรงนี้ไว้ เวลาเจองานหนักๆ ก็จะจูนได้ตรงจุด
วิธีสังเกต
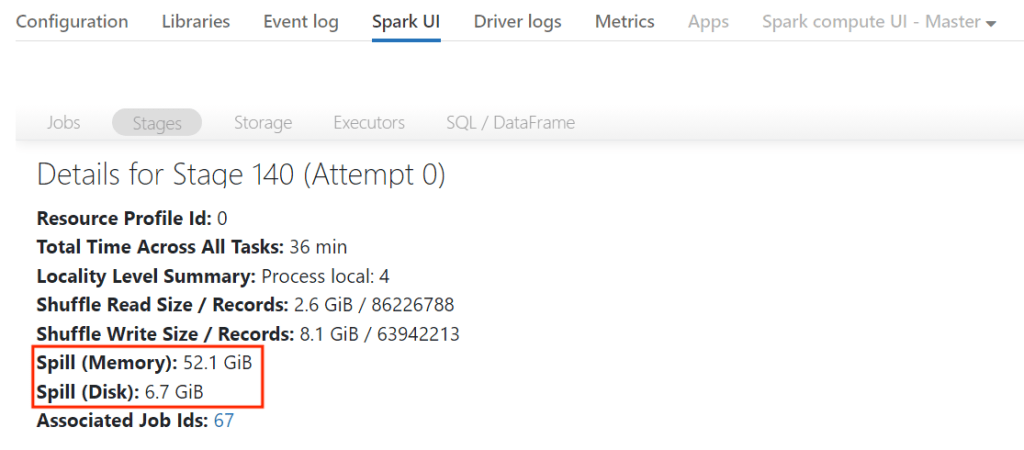
เข้าไปที่หน้า Stage Detail แล้วดู Summary Metrics for Tasks ครับ
- Partition เล็กเกินไป: Duration ต่อ Task ไม่กี่ ms, Shuffle Read ต่อ Task เป็นหลัก KB, ใน Stage มี Task เป็นร้อยเป็นพัน แต่เวลารวมส่วนใหญ่หมดไปกับ Scheduler Delay
- Partition ใหญ่เกินไป: มีคอลัมน์ Spill (Memory) / Spill (Disk) โผล่ขึ้นมา, Task ใช้เวลานานทุกตัว, หรือโดน Executor Lost จาก OOM
วิธีแก้
# ปรับให้เหมาะกับข้อมูลของงานนี้spark.conf.set("spark.sql.shuffle.partitions", "800")# หรือถ้าใช้ Spark 3.2 ขึ้นไป ให้ AQE ช่วยรวม Partition เล็กๆ ให้เองspark.conf.set("spark.sql.adaptive.enabled", "true")spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
ตอนเขียนไฟล์ก็ระวังเรื่องนี้เหมือนกันครับ ถ้า repartition(1) เพื่อให้ได้ไฟล์เดียว ทุกอย่างจะไหลเข้า Task เดียวและช้ามาก ถ้าแค่อยากลดจำนวนไฟล์ใช้ coalesce(n) จะไม่เกิด Shuffle เพิ่ม
ข้อที่ 3: Join แล้วข้อมูลเอียง (Skewed Join)
เกิดอะไรขึ้น
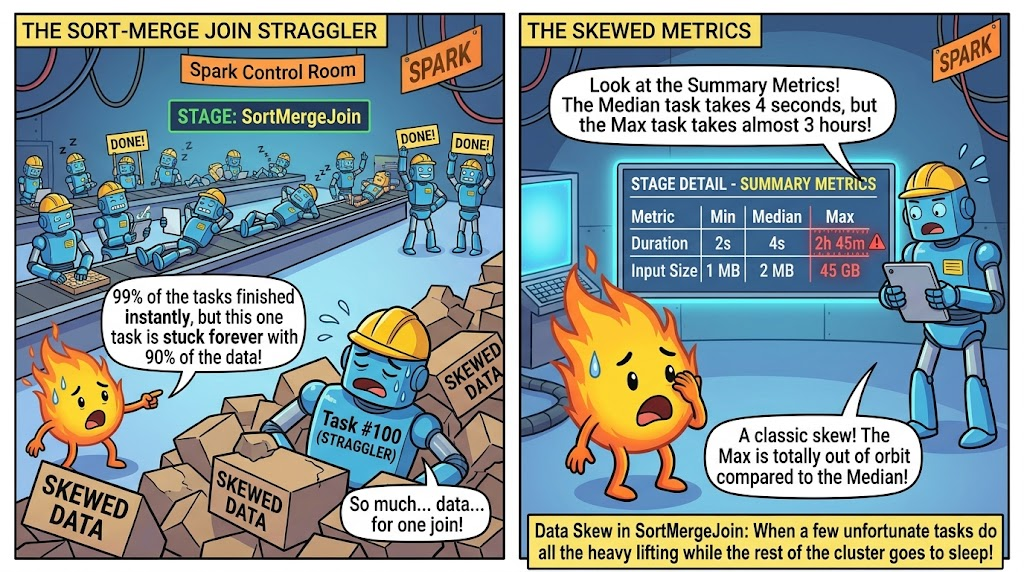
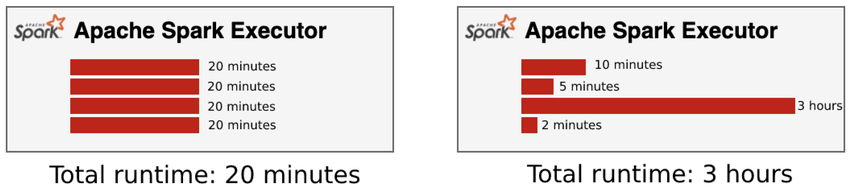
ข้อมูลจริงมักไม่กระจายเท่ากันครับ เช่นมี user_id = NULL หรือ country = 'TH' เป็น 60% ของทั้งตาราง พอ Join ด้วย Key นั้น Spark จะส่งทุกแถวที่ Key เดียวกันไปที่ Task เดียว ทำให้ Task นั้นหนักกว่าตัวอื่นเป็นสิบเท่า ส่วน Task ที่เหลือก็นั่งรอเฉยๆ
วิธีสังเกต
- ในหน้า Stage Detail ดู Summary Metrics ถ้า Max ของ Duration หรือ Shuffle Read Size ห่างจาก Median หลายเท่า นั่นคืออาการคลาสสิกของ Skew
- Progress Bar ของ Stage ค้างที่ 198/200 อยู่นานมาก
- ในแท็บ Event Timeline จะเห็น Task ตัวเดียวยาวกว่าตัวอื่นแบบเห็นได้ชัด
วิธีแก้
เรียงตามความง่ายนะครับ
- เปิด AQE Skew Join (Spark 3.x) ให้ Spark แตก Partition ที่เอียงออกเป็นชิ้นเล็กๆ เอง
- Broadcast ตารางเล็ก ถ้าอีกฝั่งเล็กพอ จะไม่ต้อง Shuffle ตารางใหญ่เลย
- กรอง Key ที่เอียงออกมาจัดการแยก เช่น NULL มักไม่ต้อง Join อยู่แล้ว
- Salting เป็นทางสุดท้าย เติมเลขสุ่มต่อท้าย Key เพื่อกระจายข้อมูล
# 1. AQEspark.conf.set("spark.sql.adaptive.enabled", "true")spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")# 2. Broadcastfrom pyspark.sql.functions import broadcastresult = big_df.join(broadcast(small_df), "country")# 3. กรอง NULL ก่อน Joinresult = big_df.filter("user_id IS NOT NULL").join(users, "user_id")
ข้อที่ 4: Shuffle ที่ไม่จำเป็น
เกิดอะไรขึ้น
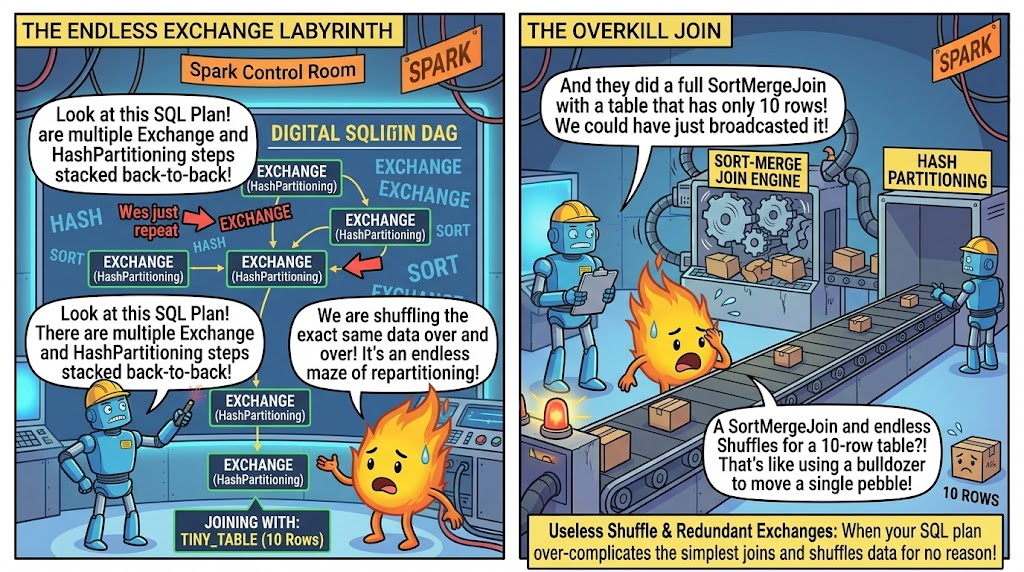
หลายครั้งที่ Shuffle เกิดขึ้นทั้งๆ ที่ไม่ต้องมี เช่น repartition() ที่ใส่ไว้ตามความเคยชิน, groupBy แล้ว join ด้วย Key เดียวกันซ้ำๆ, distinct() หลายรอบ, หรือ Join ตารางเล็กด้วย Sort Merge Join แทนที่จะเป็น Broadcast
df = ( events .repartition(200) # shuffle ไม่จำเป็น .groupBy("user_id").agg(...) # shuffle .join(users, "user_id") # shuffle อีก ทั้งที่ users เล็กมาก .distinct() # shuffle อีกรอบ)
วิธีสังเกต
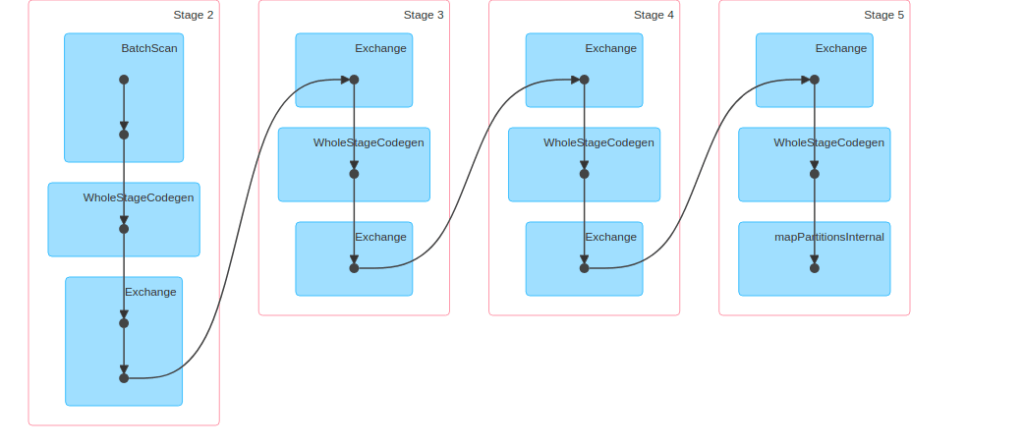
- นับกล่อง Exchange ใน DAG ครับ ยิ่งเยอะยิ่งกิน Resource ลองถามตัวเองว่าแต่ละตัวมีเหตุผลไหม
- แท็บ Stages ดูคอลัมน์ Shuffle Read / Shuffle Write ว่าสูงเกินกว่าขนาดข้อมูลจริงหรือเปล่า
- ใช้
df.explain()ดู Physical plan แล้วหาExchange hashpartitioningและSortMergeJoinที่ฝั่งหนึ่งเป็นตารางเล็ก
วิธีแก้
df = ( events .groupBy("user_id").agg(...) .join(broadcast(users), "user_id") # ตารางเล็ก ใช้ broadcast ไม่ต้อง shuffle)# distinct ออกถ้า groupBy แล้วไม่มีแถวซ้ำอยู่แล้ว
เทคนิคที่ใช้บ่อยคือ
- ลบ
repartition()ที่ไม่ได้มีเหตุผลรองรับ - ใช้
coalesce()แทนrepartition()เมื่อต้องการลดจำนวน Partition อย่างเดียว - ปรับ
spark.sql.autoBroadcastJoinThresholdให้เหมาะกับขนาดตารางเล็กของเรา - ถ้า Join ตารางใหญ่ด้วย Key เดิมซ้ำๆ ลองพิจารณา Bucketing หรือเขียน Partition ตาม Key นั้นตั้งแต่ตอนเก็บข้อมูล
- จัดลำดับให้
filterและselectเอาเฉพาะคอลัมน์ที่ใช้มาก่อน Shuffle เพื่อให้ข้อมูลที่ถูกส่งผ่าน Network น้อยลง
ข้อที่ 5: Collect ข้อมูลก้อนใหญ่เข้า Driver
เกิดอะไรขึ้น
collect(), toPandas() หรือ .rdd.collect() จะดึงข้อมูลทั้งหมดจากทุก Executor มารวมกันใน Driver ตัวเดียว ซึ่งปกติ Memory ของ Driver เล็กกว่า Executor รวมกันมาก ผลคือ Driver OOM หรือค้างไปเลยครับ และที่แย่คือโค้ดมักรันผ่านบน Dev ที่ข้อมูลน้อย แล้วไปพังบน Production
rows = df.collect() # ดึงทั้งตารางมา Driverfor r in rows: process(r)pdf = df.toPandas() # ก็เหมือนกัน
วิธีสังเกต
- Error อย่าง
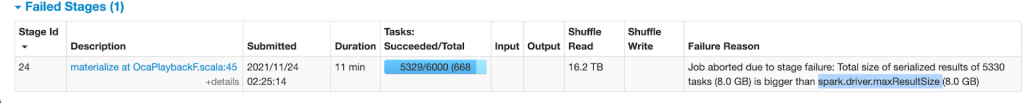
java.lang.OutOfMemoryError: Java heap spaceที่ Driver หรือTotal size of serialized results ... is bigger than spark.driver.maxResultSize - แท็บ Executors แถว driver ใช้ Memory เกือบเต็ม และ GC Time พุ่ง
- ในแท็บ Jobs เห็น Job ที่ Stage สุดท้ายมี Result Serialization / Getting Result Time สูง
- ค้นโค้ดหา
collect(),toPandas(),.count()ใน Loop แล้วจะเจอตัวการเร็วมาก
วิธีแก้
หลักคือ ให้ข้อมูลอยู่บน Executor ให้นานที่สุด แล้วค่อยเอาเฉพาะผลลัพธ์ที่เล็กพอมาที่ Driver
# ดูตัวอย่างdf.show(20)sample = df.limit(1000).toPandas()# ทำ Aggregate บน Cluster ก่อน ค่อยดึงผลลัพธ์เล็กๆ มาsummary = df.groupBy("country").count().toPandas()# ต้องวนทีละแถวจริงๆ ใช้ iterator แทน collectfor row in df.toLocalIterator(): process(row)# ผลลัพธ์ใหญ่ เขียนลง Storage ตรงๆdf.write.mode("overwrite").parquet("s3://bucket/out/")
ถ้าจะใช้ toPandas() จริงๆ เปิด Arrow ช่วยลดทั้งเวลาและ Memory ได้ด้วย spark.sql.execution.arrow.pyspark.enabled=true แต่ก็ยังควรจำกัดขนาดข้อมูลก่อนเสมอครับ
สรุปส่งท้าย
ทั้ง 5 ข้อนี้ถ้าสังเกตดีๆ จะเห็นว่าเรามองเห็นมันได้จาก Spark UI ทั้งหมดเลยครับ ไม่ต้องเดาให้เมื่อยตั้งแต่แรก เริ่มจากเปิดแท็บ SQL ดูว่ามี Exchange กี่ตัว แล้วเข้าไปดู Stage ที่ช้าที่สุดว่า Task กระจายตัวเท่ากันไหม มี Spill ไหม ส่วน Storage กับ Executors เอาไว้เช็คเรื่อง Cache และ Driver
ถ้าต้องเลือกลำดับความสำคัญ ลองไล่ตามนี้ดู
- ถ้างานช้าแบบ Task ตัวเดียวค้างอยู่นาน ให้สงสัยเรื่อง Skewed Join ก่อน
- ถ้างานช้าแบบ Task เยอะมากแต่เสร็จไวทุกตัว หรือ Spill เยอะ ให้ไปดู Partition Count
- ถ้าเห็น Exchange เต็มไปหมด ให้ไล่เช็ค Shuffle ที่ไม่จำเป็น และลอง Broadcast
- ถ้า Memory เต็มแต่ทำงานช้า ให้ลดการ Cache ลง
- ถ้า Driver พัง ให้หา
collect()/toPandas()ในโค้ดได้เลย
และข้อที่ผม ไม่ค่อยจะแนะนำ เลยคือการแก้ปัญหาด้วยการเพิ่มขนาด Cluster อย่างเดียว เพราะส่วนใหญ่แค่ทำให้ค่าใช้จ่ายสูงขึ้นแต่ปัญหาเดิมยังอยู่ ลองเปิด DAG ดูก่อนสักรอบ น่าจะประหยัดได้มากกว่าที่คิดครับ
ref:
https://spark.apache.org/docs/latest/web-ui.html
https://spark.apache.org/docs/latest/sql-performance-tuning.html
https://spark.apache.org/docs/latest/rdd-programming-guide.html#rdd-persistence


Leave a Reply