
ลองใช้ Open Knowledge Format (OKF) กับ BigQuery | จะทำให้ AI Agent เก่งขึ้นจริงหรือเปล่า?
OKF — Open Knowledge Format การเติมเต็มบริบท (Context) จะช่วย AI Agent ได้แค่ไหนกัน?
Introduction
ที่ผ่านมาเราก็ต่างมี Use case ของ AI Agent ออกมาเรื่อยๆ ทั้งในด้าน personal AI Agent หรือ AI ในองค์กรต่างก็มีเป้าหมายคนละแบบ อย่างใน Personal use ก็อาจจะเป็นเรื่อง Agent ที่เอามาทำ second brain หรือ เอาไปจัดการงานบางอย่างให้เป็น Automate — ส่วนในองค์กรก็เป็นการใช้ HR agent ถามตอบเกี่ยวกับกฎ ระเบียบต่างๆ หรือเอาไปใช้ถามตอบเกี่ยวกับข้อมูลขององค์กร ไม่ว่า Data ที่อยู่ใน Database หรือ Data warehouse.
แต่อย่างที่รู้ AI มันเก่งนะ แต่ปัญหาก็คือ AI สำหรับถามตอบข้อมูลที่เป็นข้อมูลภายในนั้น AI จะยังดึงข้อมูลไม่ค่อยแม่นยำเท่าไหร่ — ในปัจจุบันที่เราไม่ต้องมาห่วงเรื่อง AI เขียนโค้ดเท่าไหร่แล้ว ไม่ว่าจะเป็น SQL PYTHON etc…
แล้วทำไมมันถึงไม่แม่นยำละ? ก็เพราะ AI ขาดบริบท(Context) ยังไงล่ะ
บริบท(Context) — สภาพแวดล้อมที่เกี่ยวข้องและมีผลต่อการประมวลผลข้อมูลต่างๆ | ปัจจุบัน Context มีความสำคัญมากถึงขนาดว่า อาจจะกำลังมี Context engineer แล้วด้วย.
สาเหตุเกิดจากว่า AI ไม่รู้ว่าหน้าตาข้อมูลของเรา หน้าตาเป็นยังไง ไม่ว่าจะเป็น Table description, Table schema หรือ Path endpoint ต่างๆ ซึ่ง Context ของเหล่านี้สำคัญมากเลยครับ
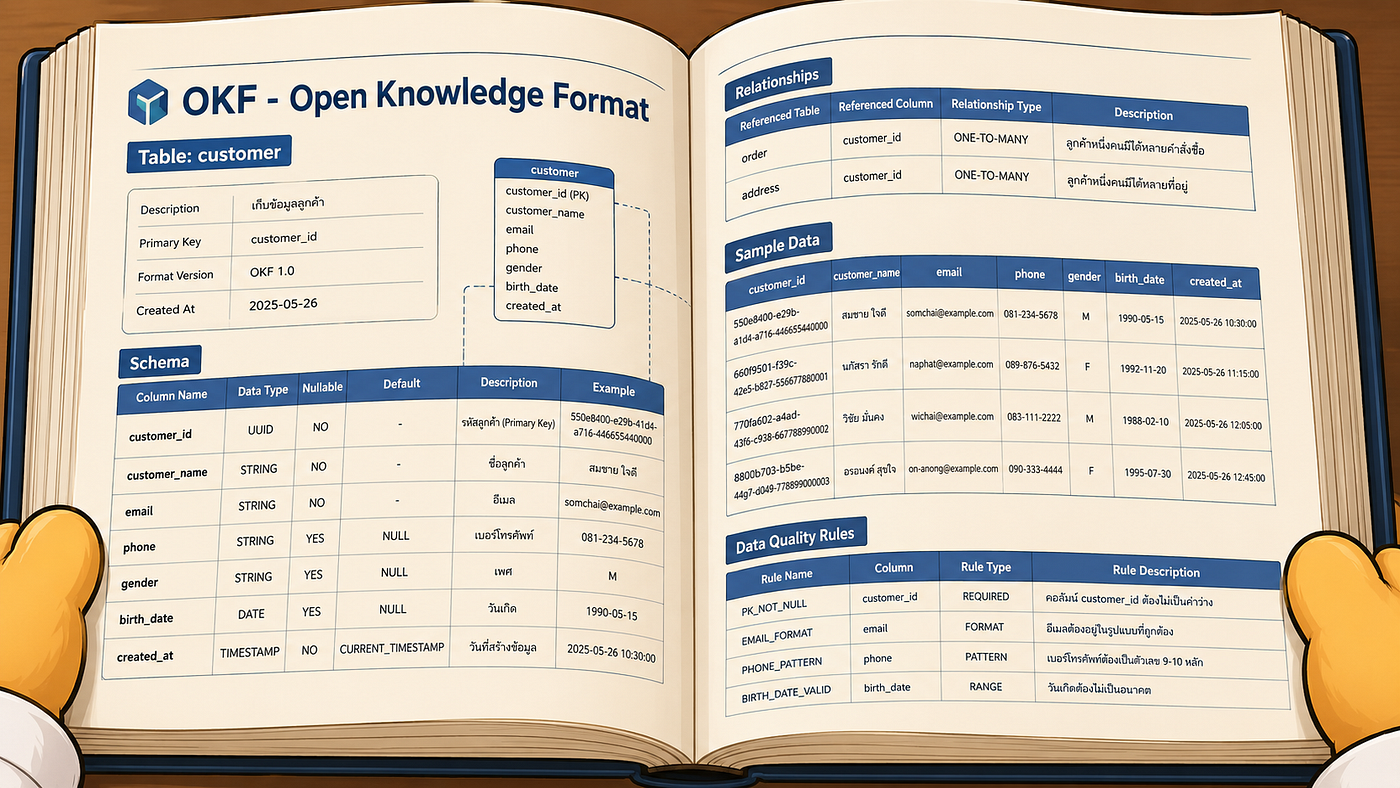
OKF — Open Knowledge Format
ด้วยการพัฒนา AI Foundation Models ในตอนนี้พัฒนาได้เก่งขึ้นเรื่อยๆ แต่เพราะการขาด Context(จากนี้ขอเขียนคำนี้เป็น eng นะครับ) ทำให้ AI ที่เก่งนั้นไม่สามารถทำงานได้อย่างเต็มที่ อย่างการบอกให้ AI ไปทำการสรุปหรือวิเคราะห์ข้อมูลก็ทำได้ยากที่จะแม่นยำ นี้แหละคือหนึ่งในแนวทางที่ Google นำเสนอเพื่อทำให้ Knowledge และ Metadata สามารถถูกนำไปใช้โดยทั้งมนุษย์และ AI Agent ได้ง่ายขึ้น ก็คือ Open Knowledge Format (OKF)
OKF — Open Knowledge Format คืออะไร?
อย่างที่ได้เขียนไปว่าตัว OKF นั้นเกิดจากที่ทีม Google เห็นจุดที่ LLM ยังขาดเรื่อง Context จึงได้พัฒนา OKF ขึ้นมา โดยได้ไอเดียจาก LLM-wiki ที่หลายๆคนเอาไปทำเป็น Second brain กัน โดยมี Obsidian เป็น Tools หลัก
โดย Google มีความตั้งใจว่าอยากให้ AI และ มนุษย์ อ่านและใช้งานได้ง่าย OKF จึงไม่ใช้การผูกติดกับ Software หรือ Vendor ไหน จะมีก็แค่ File ที่เป็น Bundle ของ OKF เท่านั้น ซึ่งประกอบไปด้วย
- File format เป็น Markdown เป็นหลัก อ่านง่าย และสามารถ Rendered ได้ดีที่ Github หรือ Git เจ้าอื่นๆ
- Files เท่านั้น Google จะบอกว่าเราไม่ได้จำเป็นต้องลง Software หรืออะไรเพิ่มเติมไปให้มากมีแค่ Files ก็พอ
- YAML frontmatter เป็นรูปแบบ Format ที่จะอยู่ในเกือบทุกๆไฟล์ เพื่อให้สามารถ Query ได้ง่าย โดย YAML นี้ประกอบไปด้วย type, title, description, resource, tags, and timestamp
เพราะงั้นแล้วถ้าใครเคยได้ใช้ Obsidian มาบ้าง ก็น่าจะคุ้นเคยกันบ้างแล้ว แต่ไม่เคยก็ไม่เป็นอะไรไม่ได้ใช้่ยากเลยครับ
การใช้งาน OKF — Open Knowledge Format
การใช้งานนั้นไม่ได้ยากอะไรเลย เราแค่ต้องรู้จักกับ Folder structure ที่เป็นหัวใจหลักก่อนก็พอ
# Example of OKF bundle - ตัวอย่าง OKF bundlesales/ # Parent folder โครงสร้าง Folder นอกสุด├── index.md├── datasets/│ ├── index.md # index.md ตัวบอกว่าไฟล์ที่อยู่ใน Folder เดียวกัน คืออะไรบ้าง│ └── orders_db.md # File ที่เป็นเนื้อหาเกี่ยวกับ Table นั้นๆ ไม่ว่าเป็น schema หรือ Description├── tables/│ ├── index.md│ ├── orders.md│ └── customers.md└── metrics/ ├── index.md └── weekly_active_users.md
ทั้งหมดนี้จึงถูกเรียกได้ว่าเป็น OKF Bundle
การ Extract dataset จาก BigQuery มาเป็น OKF bundle
เมื่อเข้าใจโครงสร้าง (Folder Structure) ของ OKF แล้ว ขั้นตอนถัดมาคือการนำข้อมูลจริงจาก Database หรือ Data Warehouse อย่าง BigQuery มาสร้างเป็น OKF Bundle เพื่อให้ AI Agent ได้เรียนรู้ context ของตาราง Schema และ Column Descriptions ต่างๆ
เราสามารถใช้ Script reference_agent ที่มีอยู่ใน Github repo ของ Google ได้เลย เพื่อนำมา Generate bundle ออกมาโดยอัตโนมัติ เนื่องจาก OKF ยังอยู่ในส่วนของการพัฒนาและยังเป็นรูปแบบ Open Format ก็เลยไม่ได้มี Tools หรือ SDK ในตอนนี้ ส่วนวิธีใช้งานคือ:
# 1 ติดตั้ง reference_agent CLIuv pip install "git+https://github.com/GoogleCloudPlatform/knowledge-catalog.git#subdirectory=okf"# หรือติดตั้งโดยการ clone repo มาก่อนgit clone https://github.com/GoogleCloudPlatform/knowledge-catalog.gitcd knowledge-catalog/okfuv pip install -e ".[dev]"
- หลังจากที่ติดตั้ง script ของ reference_agent แล้ว ตัว Script นี้จะเป็นการใช้งานในส่วนของดึงข้อมูลจาก Bigquery แล้วก็จะมีการใช้ AI ADK ในการ Enrich ข้อมูลของเรา
- การทำงานของ reference_agent จะแบ่งออกเป็น 2 Pass หลัก ที่ช่วยเติมเต็มทั้งข้อมูลโครงสร้าง (Structured Data) และข้อมูลบริบทภายนอก (Unstructured Context):
– Pass 1 (BQ Pass): ดึง Schema, Column Types, Table Name จาก BigQuery มาเป็นไฟล์ Markdown/YAML ตั้งต้น
– Pass 2 (Web Pass / Enrichment): ใช้ LLM อ่านข้อมูลจากเว็บนอก (seeds.txt) เพื่อนำ Business Definition หรือ Domain Context มาเติมใน Description และ Tags ให้อัตโนมัติ
# script reference_agent จะเป็นการทำงานสองขั้นตอน[ Data Source (BigQuery) ] ──(Pass 1: BQ Pass)──> [ Basic OKF Bundle ] │[ External Web / Docs ] ──(Pass 2: Web Pass)─> [ Reference Agent ] │ (Enrichment From external knowledge) ▼ [ Enriched OKF Bundle ]# สิ่งที่ต้องทำก่อนก็คือ # เชื่อมต่อกับ GCPgcloud auth application-default login# AI API key - แนะนำให้ใช้ free tier ของ Google AI studio - https://aistudio.google.com/export GEMINI_API_KEY=****************
- หลังจากทำด้านบนเสร็จแล้วเราจะสามารถทำขั้นตอนถัดไปได้นั้นก็คือการสร้าง bundle แล้ว
# 2. Extract Metadata และ Schema จาก BigQuery Export มาเป็น OKF Bundleuv run python -m reference_agent enrich \ --source bq \ --dataset <project>.<dataset> \ --web-seed-file <path/to/seeds.txt> \ --out ./bundles/<name># web-seed-file คือไฟล์ที่จะบอก AI ว่าให้ไปเอาข้อมูลที่ไหนมาช่วย enrich ข้อมูลเพื่อเติมเต็มบริบทข้อมูลให้มากขึ้น# ตัวอย่างข้อมูลที่มีใน BQ เป็นข้อมูล Pokemon แล้วเราอยากได้บริบทจากเว็บ Pokemon มาเติมcat << 'EOF' > seeds.txthttps://pokeapi.co/docs/v2https://bulbapedia.bulbagarden.net/wiki/Pokémon_data_structurehttps://pokemondb.net/pokedex/allEOF
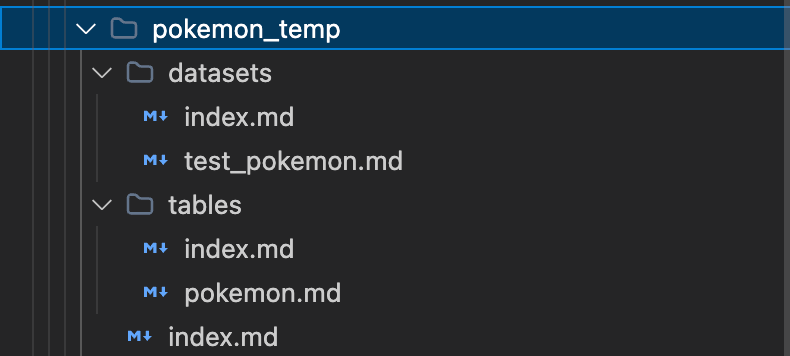
- มาลองเทียบทั้งสองรูปว่า AI ได้ทำการ enrich ข้อมูลอะไร
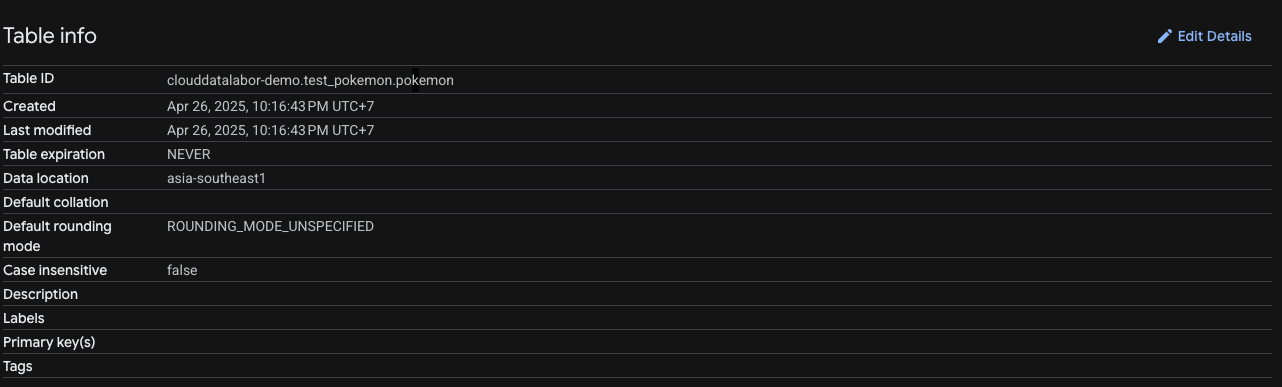
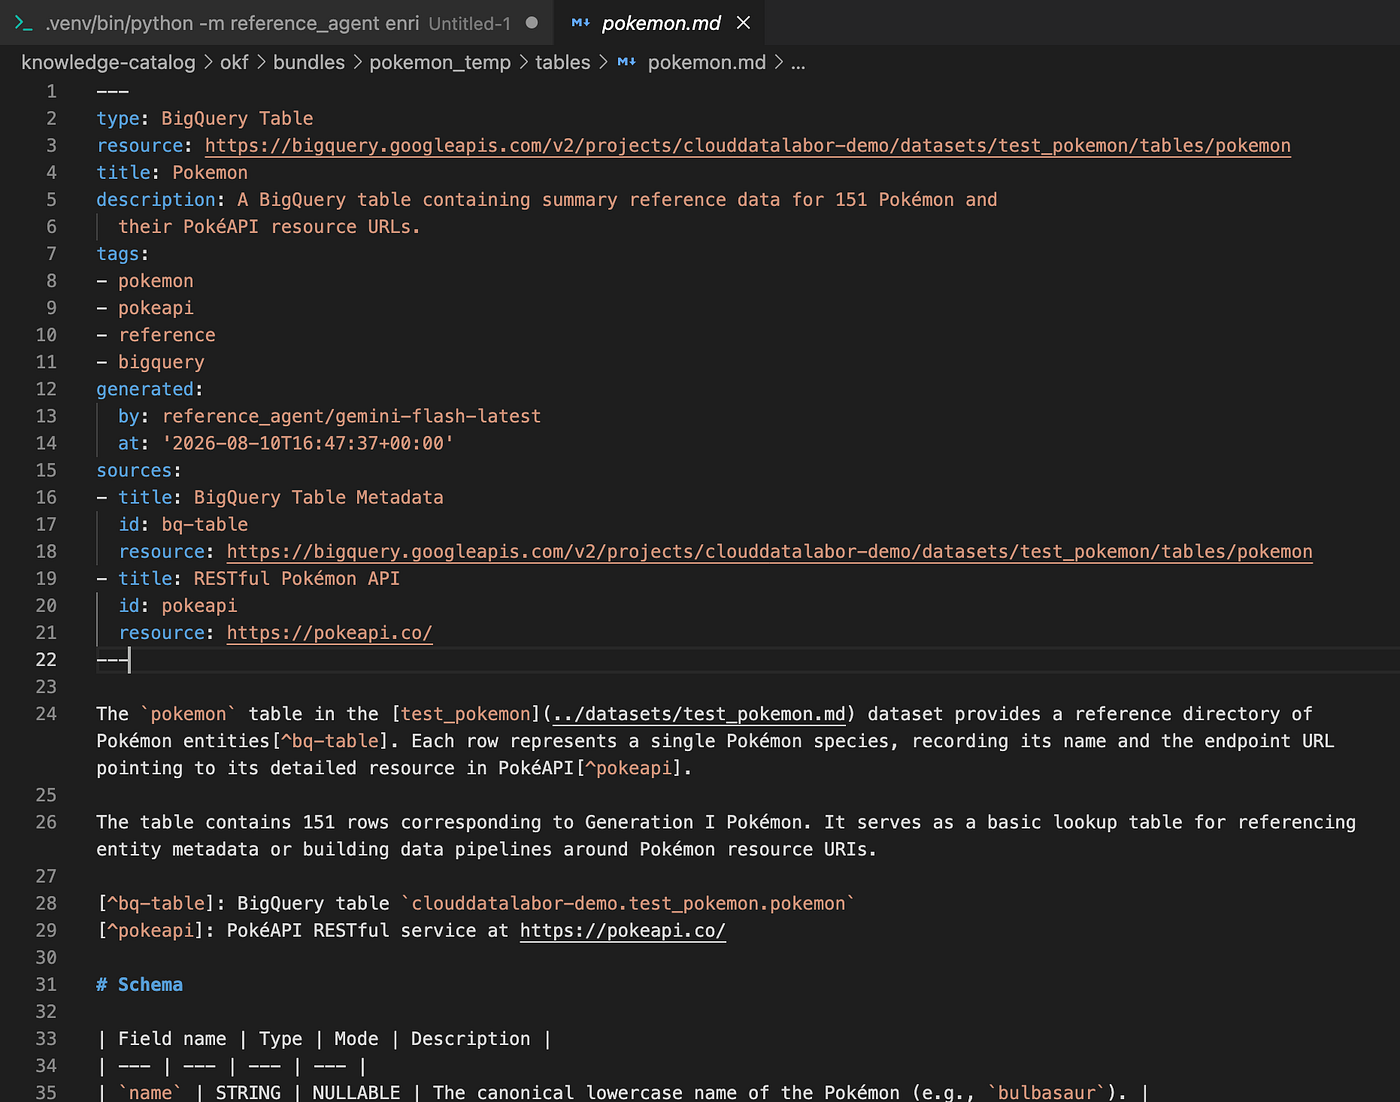
- ถ้าได้ดูข้อมูลใน Frontmatter ใน Markdown file แล้วจะเห็นว่าได้มีการเติมข้อมูลเพิ่มเข้าไปไม่ว่าจะเป็น Description, tag, source data และ อื่นๆอีก ทำให้เราได้ข้อมูลของ Table ครบถ้วนมากขึ้น
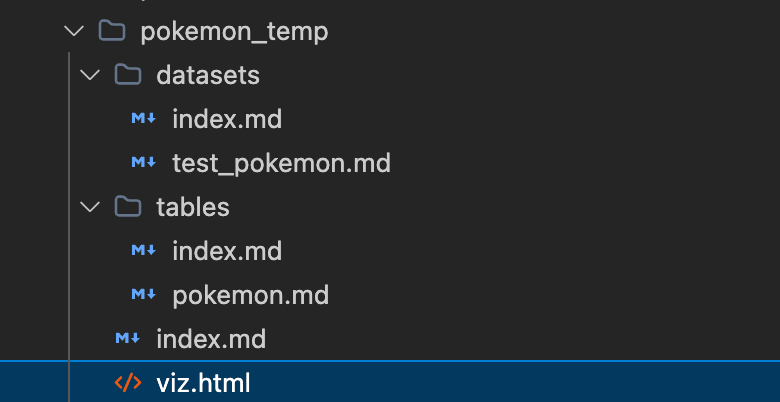
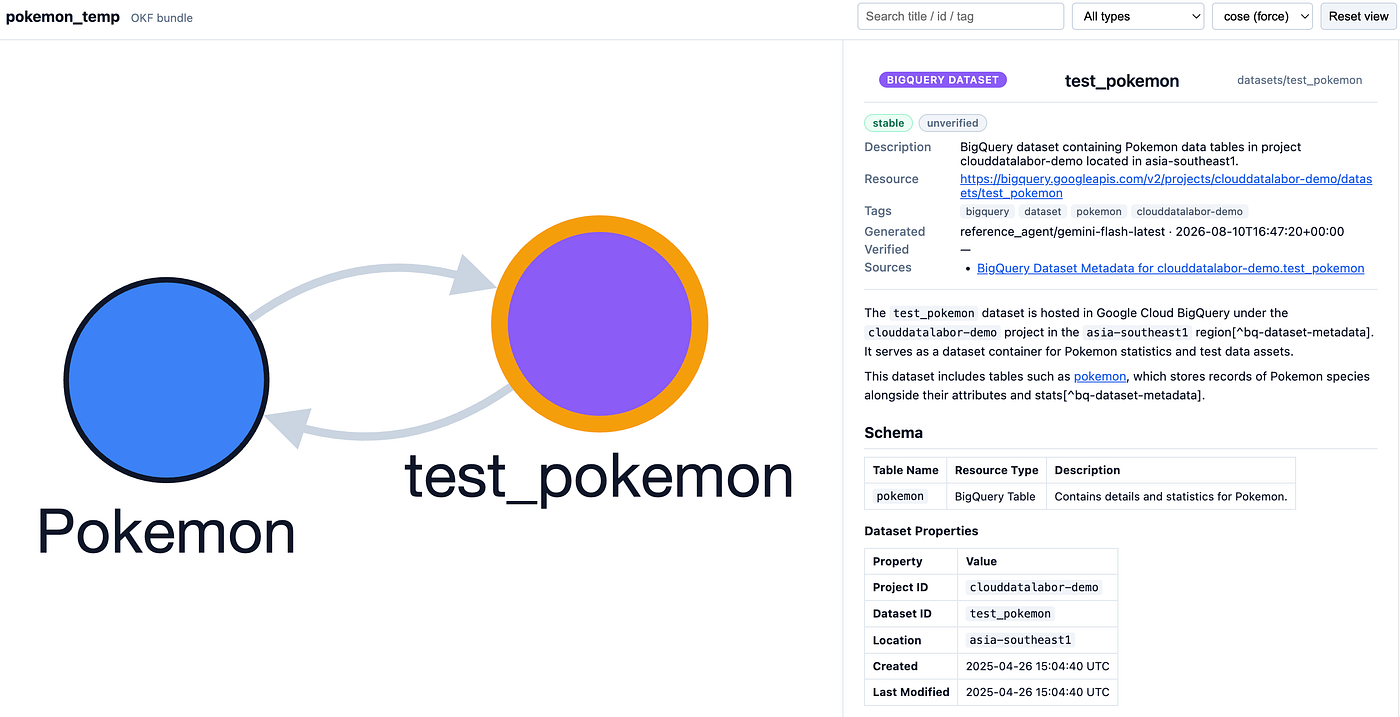
ยังไม่พอ เจ้าตัว script reference_agent ยังมีหนึ่ง function ก็คือการสร้าง Interactive Visualization: OKF มีคำสั่ง visualize เพื่อแปลงทั้ง Bundle ให้กลายเป็น HTML file แบบ Interactive Force-directed Graph ทำให้ทั้งมนุษย์และ Agent มองเห็นความสัมพันธ์ระหว่างตาราง, Metrics และเอกสารอ้างอิงได้อย่างชัดเจน
# เลือก OKF bundle เพื่อสร้าง visualize
uv run python -m reference_agent visualize --bundle ./bundles/<name>
แล้วเราก็จะได้ไฟล์ viz.html
ทดสอบให้ AI Agent Query ข้อมูลผ่าน Antigravity
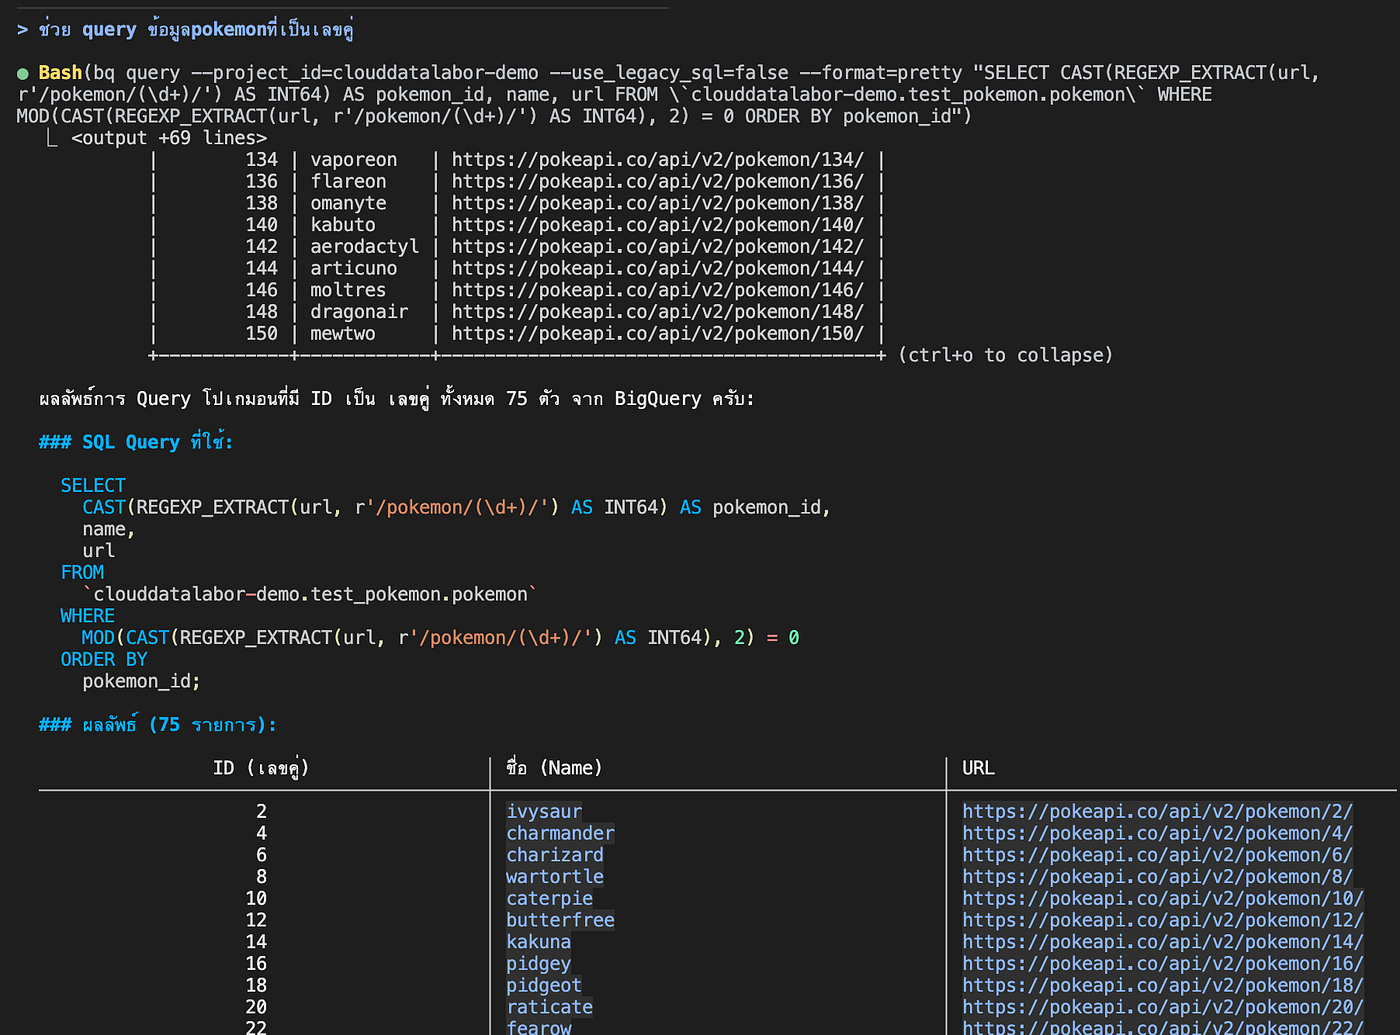
เมื่อเราได้ OKF Bundle มาแล้ว เรามาทดสอบว่า AI Agent จะสามารถใช้ Context จาก Bundle นี้ร่วมกับ Antigravity ในการแปลงคำถามภาษาธรรมชาติ (Natural Language) เป็น SQL Query แล้วไปดึงข้อมูลจริงได้แม่นยำขึ้นแค่ไหน
Prompt ทดสอบ:
“ช่วย query ข้อมูล pokemon ที่เป็นเลขคู่”
การทำงานเบื้องหลัง (Behind the Scenes)
- Context Traversal: Agent อ่าน index.md ใน OKF Bundle
- Schema & Rule Understanding: Agent ตรวจสอบ YAML Frontmatter และ Column Description ทำให้รู้ทันทีว่าต้อง Query อะไร
- Execution via Antigravity: Agent สร้าง SQL และส่งคำสั่งไปรันบน BigQuery ผ่าน Antigravity Execution Environment
ผลลัพธ์: AI Agent สามารถสร้าง Query ได้ถูกต้องเกือบ 100% โดยไม่ต้องเดาชื่อ Column หรือ Schema แบบผิดๆ ถูกๆ อีกต่อไป
สรุป (Conclusion)
การเติมเต็มบริบท (Context) ด้วย Open Knowledge Format (OKF) ช่วยแก้ปัญหาจุดสำคัญของ AI Agent ได้อย่างน่าประทับใจ และประโยชน์อื่นๆได้อีกด้วย:
- Standardized & Portable: รูปแบบ Markdown + YAML ทำให้ไม่ยึดติดกับ Vendor เจ้าใดเจ้าหนึ่ง คนอ่านเข้าใจง่าย Agent นำไปใช้ต่อได้ทันที
- ช่วยลด Hallucination: เมื่อ Agent ได้รับ Schema Description และ Relationship ที่ชัดเจน การสร้าง SQL หรือ Code เพื่อ Query ข้อมูลจึงแม่นยำขึ้นอย่างเห็นได้ชัด (ไว้มีโอกาศจะทำ Benchmark)
- สามารถเขียนโดยคนหรือ AI: ไม่จำเป็นต้องผ่าน SDK หรือ Tools อะไร แล้วยังสามารถนำไปใช้ต่อกับ Obsidian ก็ทำได้
- Data Catalog Documentation: จัดทำ Data catalog เพื่อเป็นส่วนกลางในการแชร์ Metadata ให้กับทางทีมหรือ องค์กรได้ดีเช่นกัน
นอกจากนี้แล้วตัว OKF เองก็สามารถนำไปใช้กับสิ่งอื่นๆได้อีกมากมาย บางคนเอาไปทำ RAG ก็มี(แต่เขาเอาไปดัดแปลงกันยังไงนี่สิ) แต่ถึงยังงั้นแล้วผมคิดว่าการที่มีบริบทเพิ่มเติมให้กับ AI Agent จะทำให้ความแม่นยำในการเข้าถึงข้อมูลดีขึ้นอย่างแน่นอน
*ตอนที่เขียนนี้ OKF มี version 0.2 แล้วนะครับ
Follow me here!
Linkedin:
https://www.linkedin.com/in/kriangsak-sumthong/
Facebook page:
https://www.facebook.com/profile.php?id=61563097228247
Medium:
https://medium.com/@puk.kriangsak
Website:
https://clouddatalabor.com/


Leave a comment