Data Quality in Lakehouse: มาลองใช้งาน Deequ ตรวจสอบ Data Quality บน AWS Lakehouse
ทำความรู้จักกับ Deequ และเมื่อเทียบกับ AWS Glue DQ แล้ว มาลองใช้งานกับ Iceberg บน EMR กันเถอะ
- Data Quality in Lakehouse: มาลองใช้งาน Deequ ตรวจสอบ Data Quality บน AWS Lakehouse
- Intro
- Data Quality สำคัญยังไง
- ตั้งค่า EMR ให้พร้อมใช้ Iceberg และ Deequ
- สรุป

Intro
เคยไหมครับที่เขียน Pipeline ดึงข้อมูลเข้า Data Lake ไปเรื่อย ๆ จนวันหนึ่งมี Dashboard พังเพราะจู่ ๆ ก็มีค่า Null โผล่มาในคอลัมน์ที่ไม่ควรมี Null เลย หรือแย่กว่านั้นคือไม่มีใครรู้ตัวจนกว่าฝั่ง Business จะมาทักว่าตัวเลขดูแปลก ๆ
ปัญหานี้ไม่ใช่เรื่องใหม่หรอกครับ แต่บน Data Lakehouse มันจะยิ่งเกิดง่ายกว่า Data Warehouse แบบดั้งเดิมมาก เพราะ Schema เปลี่ยนได้ตลอดเวลา มีทั้ง Batch Job และ Streaming Job หลายตัวเขียนเข้าตารางเดียวกัน แถมตอนเขียนข้อมูลก็แทบไม่มีการบังคับ Constraint เหมือนฐานข้อมูลแบบเดิมเลยด้วยซ้ำ วันนี้เลยอยากพาไปรู้จักกับ Deequ เครื่องมือ Data Quality จาก Amazon เทียบให้ดูกับ AWS Glue Data Quality ที่หลายคนอาจสับสนว่ามันคือของคนละตัวกัน แล้วปิดท้ายด้วยการลองรัน Deequ กับตาราง Iceberg บน EMR จริง ๆ กันเลยครับ
Data Quality สำคัญยังไง
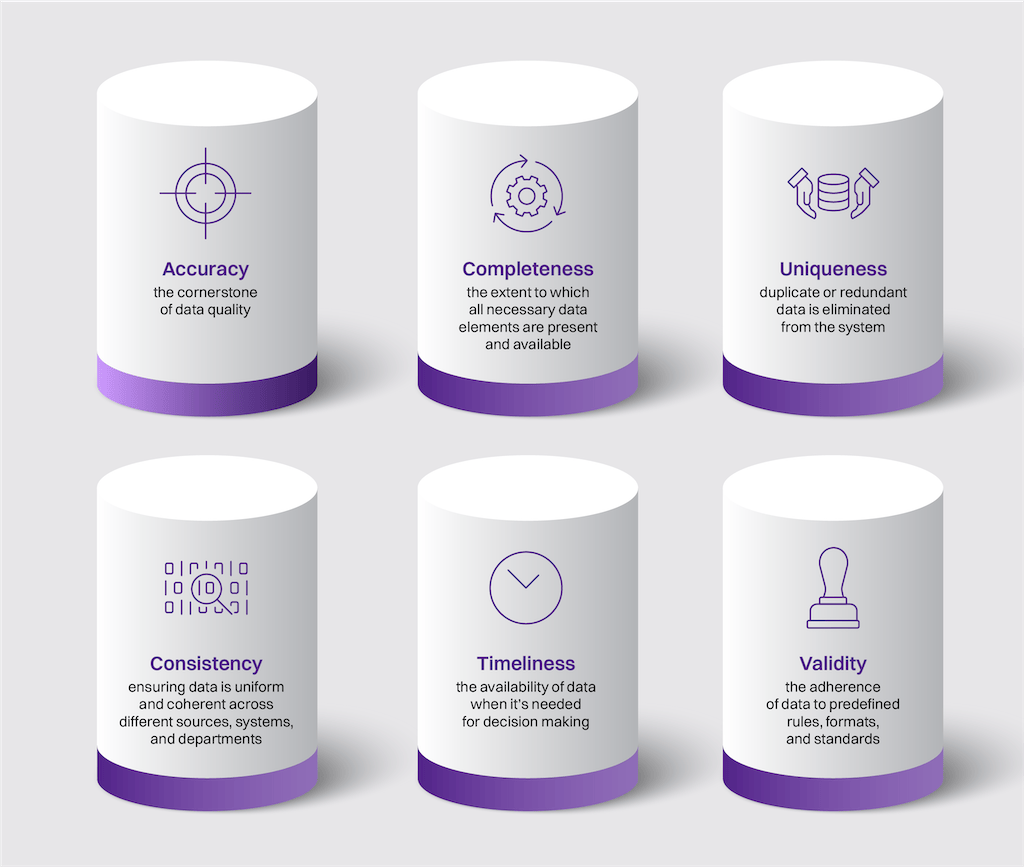
มิติหลัก ๆ ที่เราใช้วัด Data Quality กันก็หนีไม่พ้น Completeness (ข้อมูลครบไหม มี Null เยอะไหม), Uniqueness (มีข้อมูลซ้ำไหม), Validity (ค่าที่เก็บอยู่ในขอบเขตที่ควรจะเป็นไหม), Consistency (ข้อมูลจาก Source ต่างกันขัดแย้งกันไหม) และ Timeliness (ข้อมูลมาตรงเวลาที่ควรจะเป็นไหม) ครับ ฟังดูเป็นเรื่องพื้นฐาน แต่พอ Data มันไหลเข้ามาเป็น Pipeline อัตโนมัติทุกวัน การจะมานั่งเช็คด้วยตาหรือรัน Query สุ่ม ๆ มันไม่ Scale เลยครับ นี่แหละคือจุดที่ Deequ กับ AWS Glue Data Quality เข้ามาช่วยกันดีกว่า
Deequ คืออะไร
Deequ is a library built on top of Apache Spark for defining “unit tests for data”
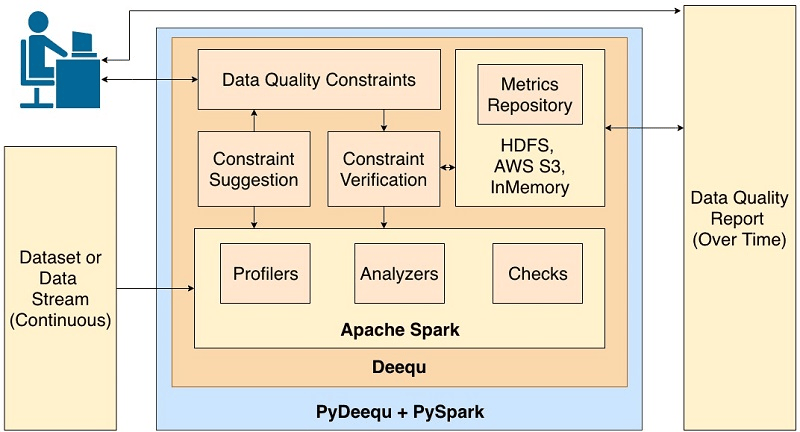
พูดง่าย ๆ Deequ ก็คือ Library โอเพนซอร์สจาก Amazon ที่เอาไว้เขียน “Unit Test ให้ข้อมูล” นั่นเองครับ ตัว Engine เขียนด้วย Scala แล้วรันบน Apache Spark โดยตรง ส่วนถ้าใครถนัด Python ก็มี PyDeequ เป็นตัว Wrapper ให้เรียกใช้งานได้เหมือนเดิมโดยที่ Engine เบื้องหลังยังเป็นตัวเดียวกันครับ
โครงสร้างของ Deequ แบ่งเป็นสี่ส่วนหลัก ๆ ที่เราจะได้ใช้กันในบทความนี้ ได้แก่
- Analyzer / AnalysisRunner คำนวณ Metric พื้นฐานของข้อมูล เช่น จำนวน Row, Completeness ของแต่ละคอลัมน์, ค่าเฉลี่ย
- Check / VerificationSuite ประกาศกฎที่ข้อมูลต้อง “ผ่าน” แล้วรันตรวจจริง ได้ผลลัพธ์เป็น Pass หรือ Fail แบบตรงไปตรงมา
- ConstraintSuggestionRunner ให้ Deequ ช่วย Profile ข้อมูลแล้วเดา Rule ที่น่าจะเหมาะให้เราแบบอัตโนมัติ ไม่ต้องนั่งคิดเองทุกกฎ
- Metrics Repository เก็บผลลัพธ์ย้อนหลังไว้ดู Trend ของคุณภาพข้อมูลตามเวลา
แล้ว AWS Glue Data Quality ล่ะ ต่างกันตรงไหน
อันนี้คือจุดที่คนมักเข้าใจผิดกันบ่อยครับ หลายคนคิดว่า Deequ กับ AWS Glue Data Quality เป็นคนละตัว แต่จริง ๆ แล้ว AWS Glue Data Quality ถูกสร้างขึ้นบน Deequ โดยตรง ครับ พูดง่าย ๆ คือ Glue DQ เอา Engine ของ Deequ มาห่อเป็นบริการ Managed Service ที่ใช้งานง่ายขึ้น มี UI ให้กดคลิก มีภาษาเฉพาะของตัวเองเรียกว่า DQDL (Data Quality Definition Language) สำหรับเขียน Rule แบบไม่ต้องเขียนโค้ด Spark เอง แถมยังมี ML-based Anomaly Detection และปุ่ม Recommend Rule ที่ช่วยแนะนำกฎให้แบบสองคลิกจบ ซึ่งพอเข้าใจแบบนี้แล้วคำถามที่ถูกต้องจึงไม่ใช่ “จะเลือก Deequ หรือ Glue DQ ดี” แต่เป็น “จะเข้าถึง Engine ตัวเดียวกันนี้แบบ Raw Code หรือแบบ Managed Service ดีมากกว่าครับ”
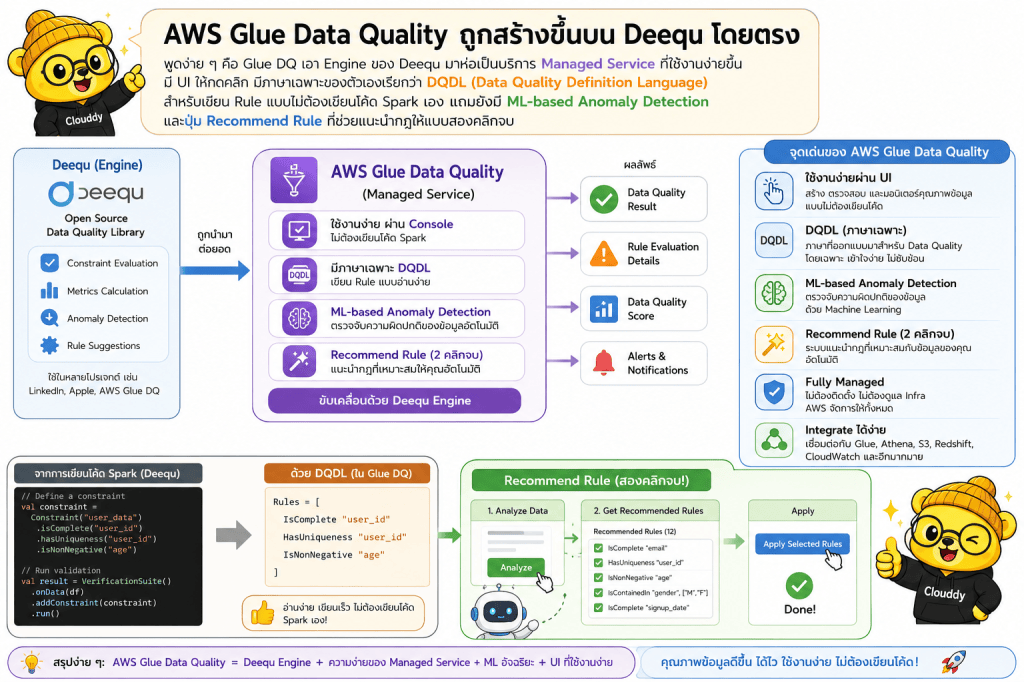
ความเหมือนที่แตกต่าง
- การควบคุม (Control): Deequ เขียนโค้ดเองได้เต็มที่ ผูก Logic ซับซ้อนแค่ไหนก็ได้ ส่วน Glue DQ ถูกจำกัดด้วยภาษา DQDL ที่ทำได้ตาม Rule ที่รองรับเท่านั้น
- ที่รัน: Deequ รันได้ทุกที่ที่มี Spark ไม่ว่าจะ EMR, Glue Job, หรือ Databricks ส่วน Glue DQ ผูกอยู่กับ AWS Glue โดยเฉพาะ
- โมเดลค่าใช้จ่าย: Deequ ฟรีเพราะเป็นโอเพนซอร์ส แต่คุณต้องจ่ายค่า Compute เอง ส่วน Glue DQ คิดเงินตาม DPU ที่ใช้รันแบบ Managed Service
- การรองรับ Iceberg: Glue DQ รองรับตาราง Iceberg, Delta Lake, Hudi ที่จัดการผ่าน Lake Formation ได้ตรง ๆ ในขณะที่ Deequ จะรองรับ Iceberg ผ่าน Spark DataFrame ธรรมดา ต้อง Config Catalog เองก่อน
- เหมาะกับใคร: ถ้ากำลัง Prototype, อยากผูกเข้ากับ Pipeline ที่มี Logic เฉพาะทาง หรือทำงานใน Jupyter Notebook อยู่แล้ว Deequ จะยืดหยุ่นกว่า แต่ถ้าอยากได้ระบบ Managed ที่ดูแล Infra น้อยลง มี UI ให้ทีมที่ไม่ถนัดโค้ดใช้งานได้ Glue DQ จะตอบโจทย์กว่าครับ
พอเห็นภาพเปรียบเทียบกันแล้ว มาลองของจริงกันดีกว่าครับ คราวนี้จะพาไปตั้งค่า EMR ให้รองรับ Iceberg ผ่าน Glue Catalog แล้วรัน Deequ ตรวจสอบข้อมูลบนตารางนั้นผ่าน Jupyter Notebook กันเลย
ตั้งค่า EMR ให้พร้อมใช้ Iceberg และ Deequ
ก่อนอื่นต้องบอกก่อนว่า EMR ตั้งแต่เวอร์ชัน 6.5.0 เป็นต้นมารองรับ Iceberg แบบ Native อยู่แล้วครับ ไม่ต้องยุ่งกับ Bootstrap Action เพื่อลง Jar เองเหมือนสมัยก่อน แค่เปิด Classification iceberg-defaults ตอนสร้าง Cluster เท่านั้นเอง
[ { "Classification": "iceberg-defaults", "Properties": { "iceberg.enabled": "true" } }, { "Classification": "spark-defaults", "Properties": { "spark.sql.catalog.glue_catalog": "org.apache.iceberg.spark.SparkCatalog", "spark.sql.catalog.glue_catalog.catalog-impl": "org.apache.iceberg.aws.glue.GlueCatalog", "spark.sql.catalog.glue_catalog.io-impl": "org.apache.iceberg.aws.s3.S3FileIO", "spark.sql.catalog.glue_catalog.warehouse": "s3://BUCKET-NAME/iceberg-warehouse/", "spark.sql.defaultCatalog": "glue_catalog", "spark.sql.extensions": "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions", "spark.jars": "s3://BUCKET-NAME/jars/deequ-2.0.7-spark-3.5.jar", "spark.yarn.appMasterEnv.SPARK_VERSION": "3.5", "spark.executorEnv.SPARK_VERSION": "3.5" } }]
จุดสำคัญอยู่ที่ spark.sql.catalog.glue_catalog ครับ เรากำลังบอก Spark ว่าให้ใช้ AWS Glue Data Catalog เป็น Catalog ของ Iceberg โดยตั้งชื่อ Catalog นี้ว่า glue_catalog ส่วนบรรทัดสุดท้ายคือการใส่ Jar ของ Deequ เข้าไปในเครื่อง Spark เลย ตั้งแต่ตอน Cluster เริ่มทำงาน จะได้ไม่ต้อง Config อะไรเพิ่มตอนอยู่ใน Notebook อีก
ส่วน pydeequ เป็น Python Package ที่ต้องลงแยกผ่าน Bootstrap Action เพราะมันไม่ใช่ Jar ที่ Spark โหลดเองได้ ต้องให้มีอยู่บนทุก Node ของ Cluster
set -euo pipefailPYDEEQU_VERSION="${PYDEEQU_VERSION:-1.4.0}"# pydeequ installs fine with the image's stock pip.sudo pip3 install "pydeequ==${PYDEEQU_VERSION}"sudo yum reinstall -y python3-dateutilecho "pydeequ installed:"pip3 show pydeequ | grep -E "^(Name|Version)"
จากนั้นก็สั่ง Create Cluster ผ่าน AWS CLI พร้อมเปิด Application JupyterHub ไว้เลย จะได้มี Notebook ให้เปิดใช้งานได้ทันทีที่ Cluster พร้อม
aws emr create-cluster \ --name "deequ-iceberg-demo" \ --release-label emr-7.2.0 \ --applications Name=Hadoop Name=Spark Name=JupyterHub Name=Livy \ --configurations file://01_emr-configurations.json \ --use-default-roles \ --ec2-attributes SubnetId=subnet-xxxxxxxx,KeyName=your-ec2-keypair \ --instance-type m5.xlarge \ --instance-count 3 \ --bootstrap-actions Path=s3://YOUR-BUCKET/bootstrap/bootstrap-pydeequ.sh \ --log-uri s3://YOUR-BUCKET/emr-logs/ \ --region us-east-1
พอ Cluster ขึ้นสถานะ WAITING แล้ว ก็เปิด JupyterHub ผ่าน https://<master-public-dns>:9443 ได้เลยครับ
มาเขียน Notebook ตรวจข้อมูลกันจริง ๆ
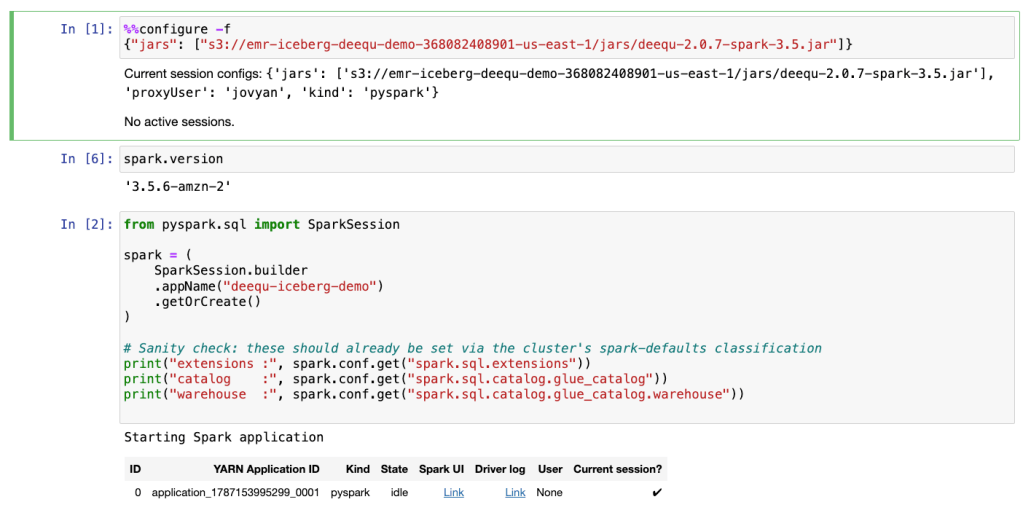
เริ่มจากสร้าง Spark Session แบบธรรมดา เพราะ Config ทั้งหมดถูกฝังไว้ที่ระดับ Cluster ตั้งแต่ต้นแล้ว ไม่ต้องมานั่ง Config ซ้ำใน Notebook อีก (ต่อจากอันนี้จะเป็น Screenshot จาก jupyter notebook ครับ โค้ดสามารถดูได้ที่ Github repo ทื่อยู่ด้านล่างสุด)
ในรูปอาจจะมีชื่อ Bucket หรือ Account ติดไปด้วย แต่ไม่ต้องด่าผมนะครับ เป็น Account ส่วนตัว แล้วก็หลังจากเขียน Blog ผมก็ลบหมดเลย 😎
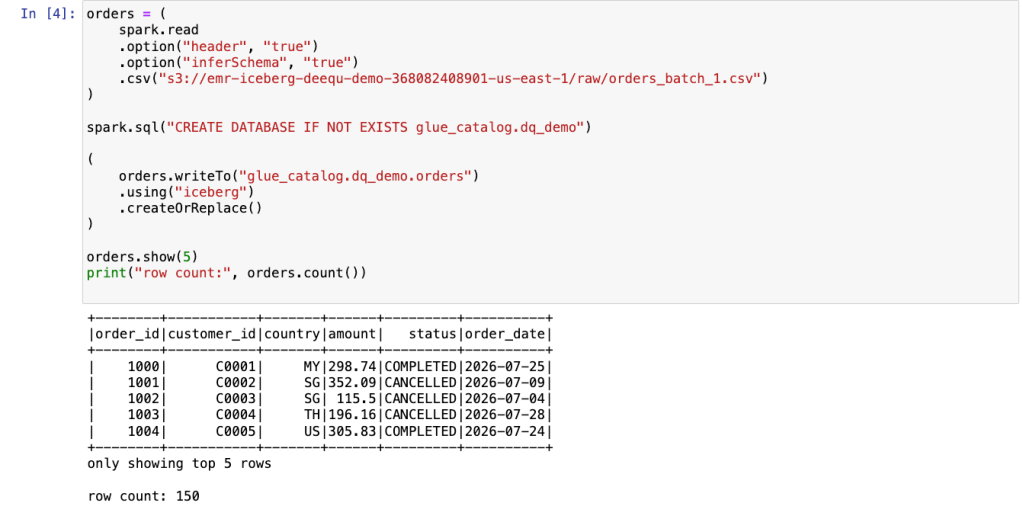
ต่อมาลองสร้างตาราง Iceberg ตัวอย่างชื่อ orders ผ่าน glue_catalog โดยจงใจใส่ข้อมูลที่มีปัญหาปนเข้าไปด้วย เช่น customer_id เป็น Null, order_id ซ้ำกัน และ amount ติดลบ เพื่อให้เห็นว่า Deequ ตรวจจับได้จริง
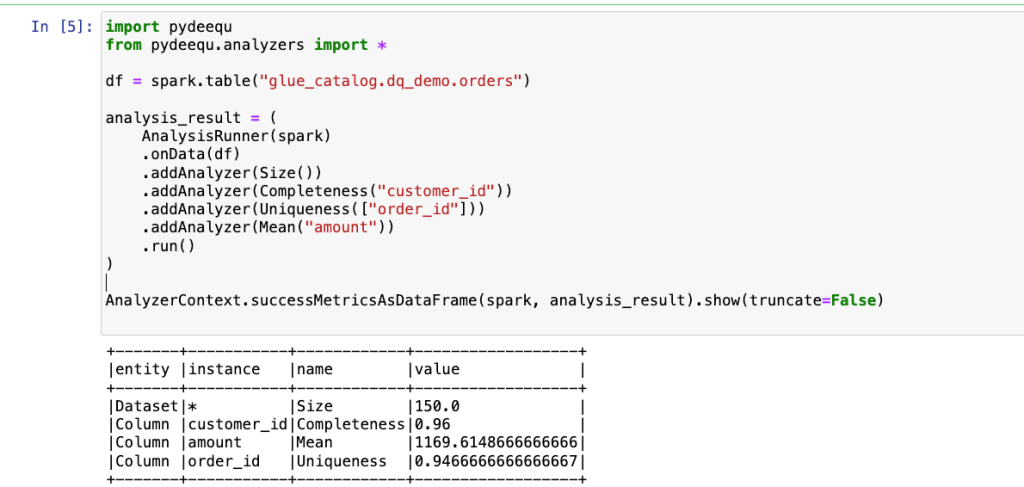
ก่อนจะเริ่มทำการ Check Data Quality ก็มาลองดู Data Profile กันก่อน เช่นพวก Average, Completeness และ Uniqueness เป็นต้น
จากนั้นก็มาถึงส่วนหลักครับ ประกาศ Check แล้วรัน VerificationSuite ตรวจตารางนี้
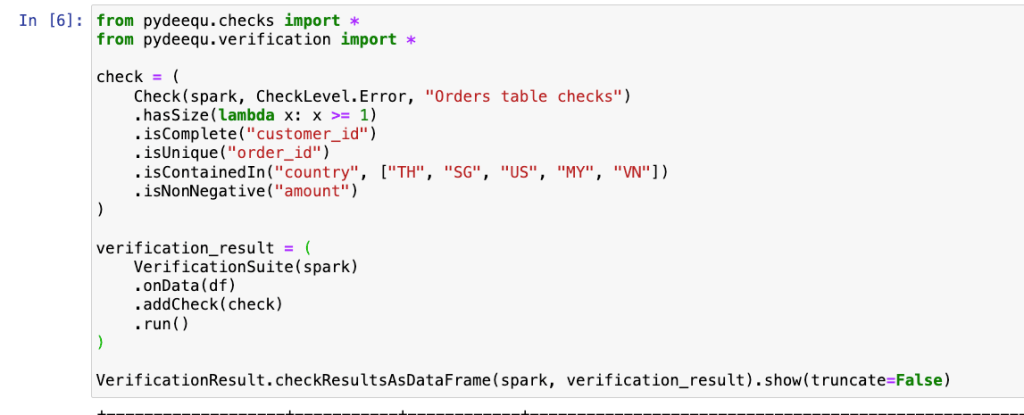
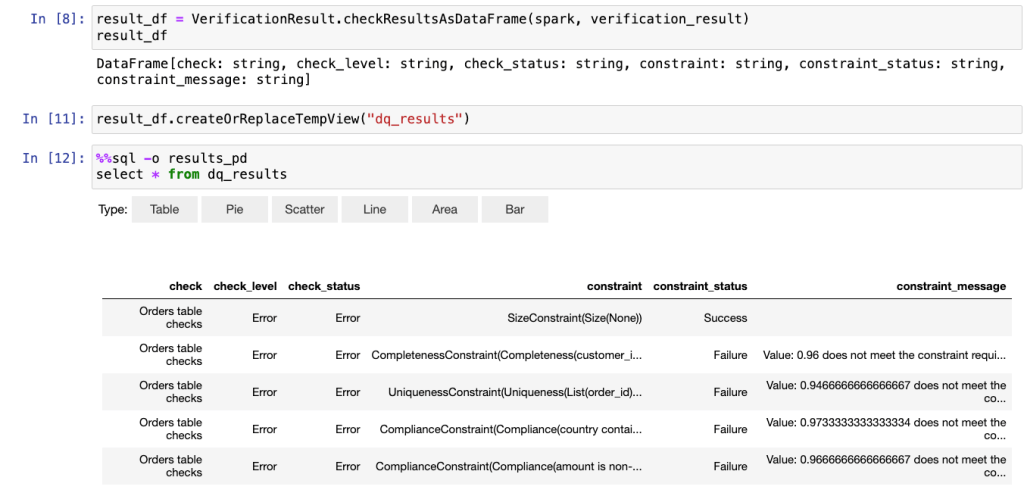
รันแล้วจะเห็นเลยครับว่า isComplete("customer_id"), isUnique("order_id") และ isNonNegative("amount") ขึ้น Failure ตามที่เราจงใจใส่ปัญหาไว้ตั้งแต่แรก
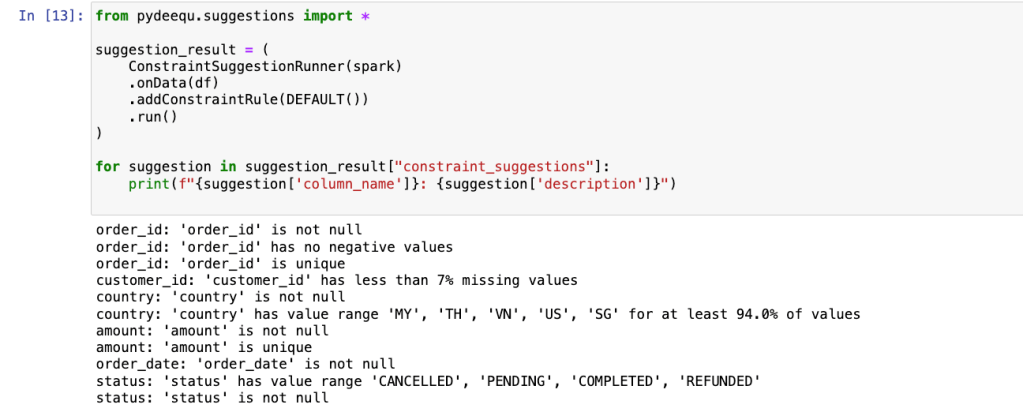
ส่วนใครขี้เกียจนั่งคิด Rule เองทั้งหมด ก็ให้ Deequ ช่วย Suggest ให้ได้เหมือนกัน ผ่าน ConstraintSuggestionRunner ซึ่งแนวคิดนี้คล้ายกับปุ่ม Recommend Rule ของ Glue DQ เลยครับ
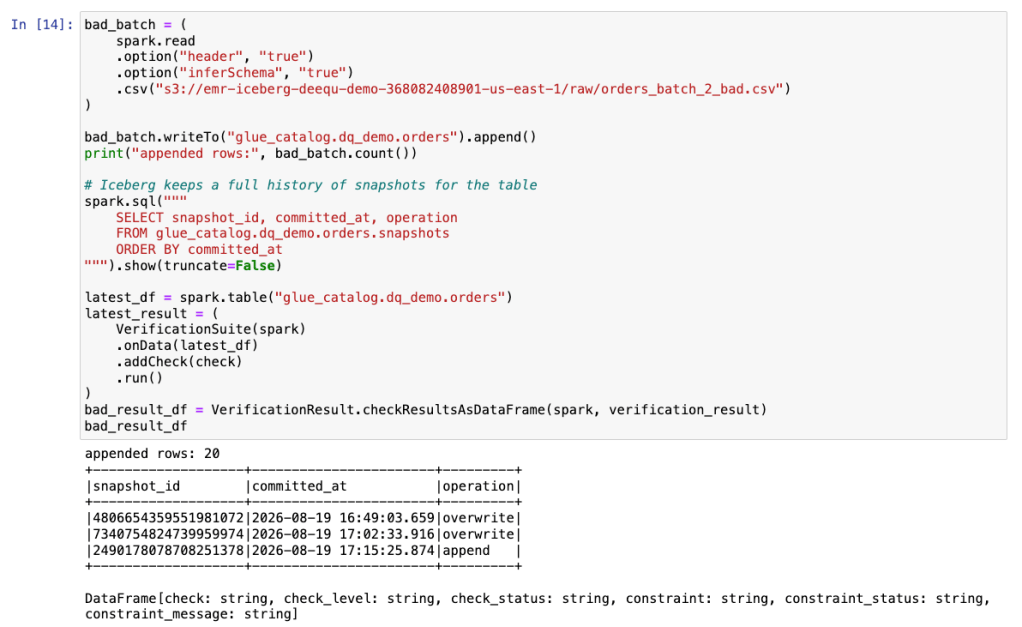
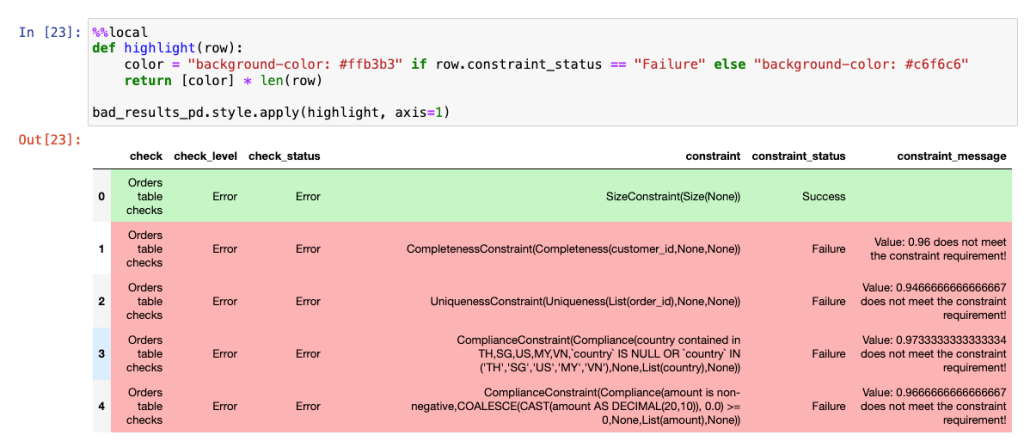
แต่ที่น่าสนใจกว่านั้นคือพอเป็นตาราง Iceberg เราสามารถ Append ข้อมูลชุดใหม่เข้าไปแล้วรัน Check เดิมซ้ำเพื่อจับ Regression ของคุณภาพข้อมูลได้ทันที
โดยดู Snapshot History ของ Iceberg ประกอบไปด้วยว่า Snapshot ไหนที่ทำให้คะแนนตก ซึ่งเป็นจุดที่ Deequ กับ Iceberg เข้ากันได้ดีกว่า Flat File ทั่วไปมากครับ
สรุป
Deequ กับ AWS Glue Data Quality เป็น Engine เดียวกันที่ให้เข้าถึงคนละแบบครับ ถ้ากำลังอยู่ในช่วง Prototype, อยากผูก Logic เฉพาะทางเข้ากับ Pipeline ที่มีอยู่แล้ว หรือทำงานบน Jupyter Notebook เป็นหลักอยู่แล้ว แนะนำให้ใช้ Deequ ตรง ๆ ผ่าน EMR เพราะควบคุมได้เต็มที่และไม่มีค่าใช้จ่ายเพิ่มจากตัว Engine เอง แต่ถ้าทีมไม่อยากดูแล Infra เอง อยากได้ UI ให้คนที่ไม่ถนัดโค้ดมาช่วยตั้ง Rule ได้ หรือมีตาราง Iceberg ที่จัดการผ่าน Lake Formation อยู่แล้ว Glue Data Quality จะสะดวกกว่ามาก เพราะมันคือ Deequ ตัวเดิมที่ห่อให้ใช้ง่ายขึ้นนั่นเองครับ
แล้วก็ต่อให้ไม่ได้ใช้ Service ของ AWS ก็นำไปใช้ได้นะครับ😇
ส่วนเรื่อง Iceberg เองก็เป็นตัวช่วยสำคัญที่ทำให้เรื่อง Data Quality สนุกขึ้นไปอีกขั้น เพราะมี Snapshot History ให้ย้อนดูได้ว่า Data Quality เริ่มเน่าไปตอนไหน
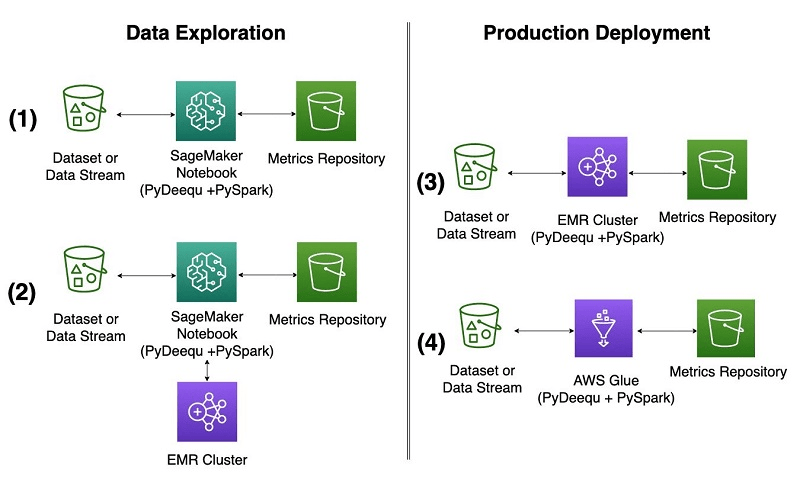
แถมตัวอย่างจาก AWS Production Deployment:
Github repo:
https://github.com/kriangsak-puk/clouddatalabor-demo-aws-deequ-emr
ref:
https://docs.aws.amazon.com/emr/latest/ReleaseGuide/emr-iceberg-use-spark-cluster.html
https://github.com/awslabs/python-deequ https://docs.aws.amazon.com/glue/latest/dg/glue-data-quality.html


Leave a comment