ผมไปเจอคลิปหนึ่งของช่อง DataExpert ชื่อว่า “Processing 2000 TBs per day of network data at Netflix with Spark and Airflow” แค่อ่านชื่อก็ชวนให้คิดต่อแล้วว่า ในสเกลข้อมูลระดับนี้ การเลือกวิธี join ผิดเพียงจุดเดียว ต้นทุนและเวลาจะบานปลายไปขนาดไหน แม้ในงานจริงผมจะเอาเคสของบริษัทมาเปิดโชว์ไม่ได้ 😆 และสเกลข้อมูลในไทยอาจจะไม่ได้วิ่งไปถึงระดับ 2,000 TB ต่อวันแบบ Netflix (แต่ที่ดูแลอยู่ก็หนักเอาเรื่องอยู่นะ 🥹)
หลักการเบื้องหลังที่ใช้รับมือกับมันกลับเป็นเรื่องเดียวกันทั้งหมด Blog นี้เลยขอพาไปเจาะลึกฝั่งกลไกและทฤษฎีแบบเน้นๆ ว่า Join ใน Spark มีกี่แบบ แต่ละแบบทำงานข้างในยังไง และ Spark ตัดสินใจเลือกวิธีไหนให้เราครับ
ทำไม Join ถึงเป็นเรื่องใหญ่บน Big Data
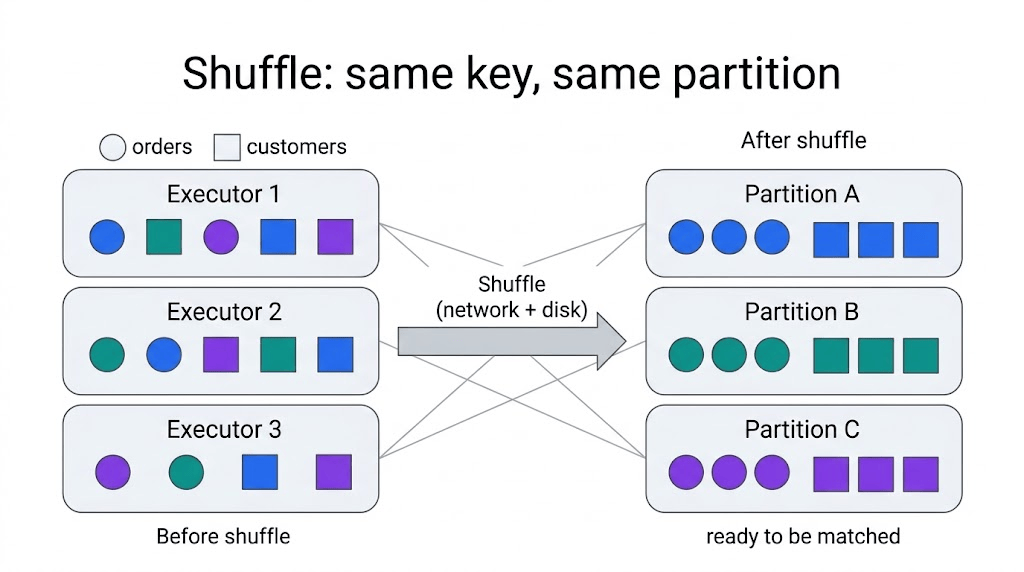
ถ้าเป็น Database ตัวเดียว การ join ก็คือเอาสองตารางมาจับคู่กันด้วย key แล้ว Engine ก็ทำจบในเครื่องเดียว แต่ทีนี้ใน Spark ข้อมูลถูกแบ่งเป็น Partition กระจายอยู่ตามเครื่องต่างๆ
เช่น แถวที่ customer_id = 42 ของตารางซ้ายอาจอยู่เครื่องหนึ่ง ในขณะที่แถว customer_id = 42 ของตารางขวาไปอยู่อีกเครื่อง ก่อนจะจับคู่กันได้ก็ต้องเอาแถวที่ key เดียวกันมากองรวมไว้ที่เดียวกันก่อน
กระบวนการย้ายข้อมูลข้ามเครื่องแบบนี้เรียกว่า Shuffle ซึ่งต้องเขียนลงดิสก์ ส่งผ่านเครือข่าย แล้วอ่านกลับมาอีกที เป็นส่วนที่แพงที่สุดของ job ส่วนใหญ่เลยครับ สรุปง่ายๆ ได้ว่า
Join คือการทำให้ key เดียวกันมาเจอกัน ส่วน Shuffle คือราคาที่ต้องจ่ายเพื่อให้มันเจอกัน
ทั้งบทความนี้จึงวนอยู่กับคำถามเดียวคือ จะทำยังไงให้จ่ายราคานี้น้อยที่สุดครับ
“ราคา” ในที่นี้คือเวลาและทรัพยากรที่ต้องเสียไปกับการขนข้อมูลข้ามเครื่อง ทุกแถวที่ต้องย้ายจะถูกแปลงเป็น bytes เขียนลงดิสก์ ส่งผ่านเครือข่าย แล้วอ่านกลับมารวมกันที่ปลายทาง ยิ่งข้อมูลเยอะก็ยิ่งแพงทั้งเวลา Network Disk และ memory
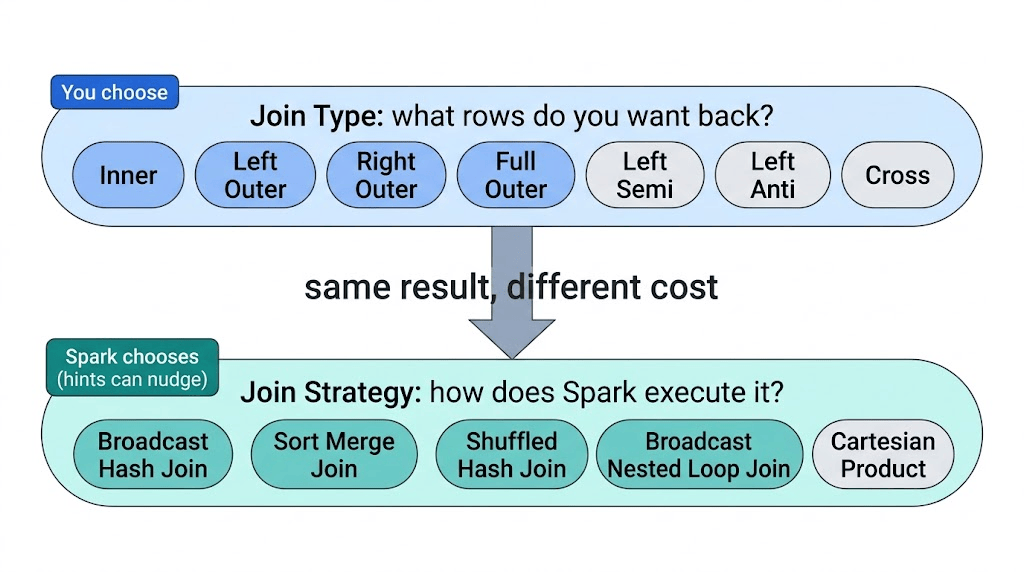
Join Type กับ Join Strategy คนละเรื่องกันเลย
สองคำนี้มักถูกปนกันบ่อยมากและทำให้สับสนเวลาพูดถึง ขอแยกให้ชัดก่อน
- Join Type ตอบคำถามว่า “อยากได้แถวอะไรกลับมา” เช่น Inner, Left, Full เป็นเรื่องของความหมายเชิงตรรกะ ผลลัพธ์ต้องออกมาเหมือนกันไม่ว่า Spark จะรันด้วยวิธีไหน
- Join Strategy ตอบคำถามว่า “Spark จะลงมือทำยังไง” เช่น Broadcast Hash Join, Sort Merge Join เป็นเรื่องของประสิทธิภาพล้วนๆ ผลลัพธ์เหมือนเดิม แต่เวลาและทรัพยากรที่ใช้ต่างกันได้มหาศาล
เราเป็นคนเลือก Join Type ส่วน Join Strategy นั้น Spark จะเลือกให้ (และเราก็สามารถไปชี้นำมันได้ด้วย Hint ซึ่งจะเล่าให้ฟังด้านล่างครับ)
Join Type: อยากได้แถวอะไรกลับมา
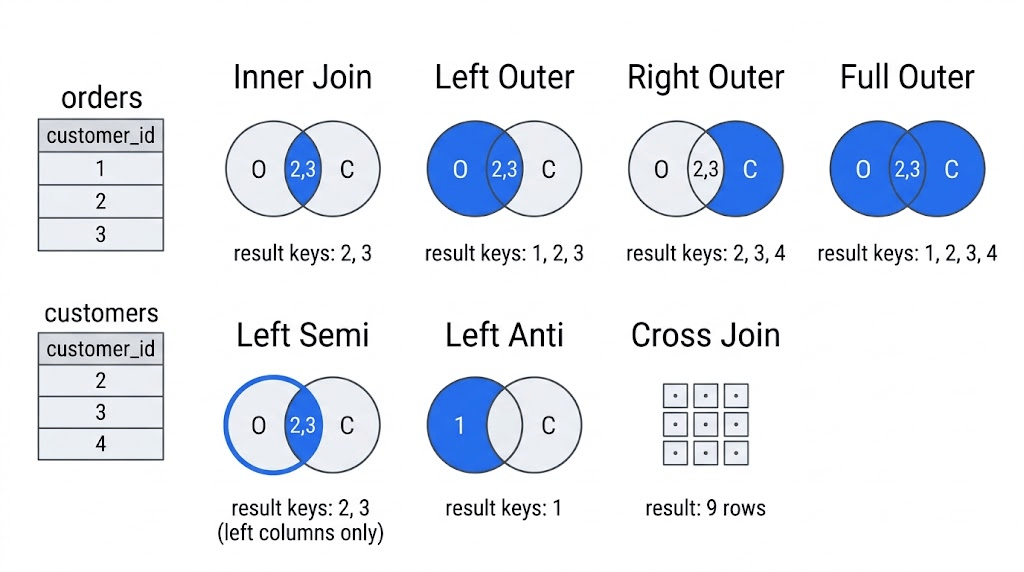
เพื่อให้เห็นภาพ สมมติว่ามีสองตารางที่ key ไม่ตรงกันเสียทีเดียว
orders : customer_id = 1, 2, 3customers : customer_id = 2, 3, 4
ตาราง orders มีลูกค้าหมายเลข 1 ที่ไม่มีอยู่ในตาราง customers และตาราง customers ก็มีลูกค้าหมายเลข 4 ที่ยังไม่เคยสั่งซื้อ คราวนี้ลองดูว่าแต่ละ Join Type จะให้อะไรกลับมาบ้าง
- Inner Join: เอาเฉพาะ key ที่เจอทั้งสองฝั่ง ได้ลูกค้า 2 กับ 3 เป็นค่า default ของ Spark SQL เลยครับ
- Left Outer Join: เก็บทุกแถวของ orders ไว้ครบ ใครไม่มีคู่ฝั่งขวาก็ได้ค่า NULL ในคอลัมน์ของ customers ได้ลูกค้า 1, 2, 3
- Right Outer Join: กลับด้านกับ Left เก็บทุกแถวของ customers ได้ลูกค้า 2, 3, 4
- Full Outer Join: เก็บทั้งสองฝั่ง ฝั่งไหนไม่มีคู่ก็เติม NULL ได้ลูกค้า 1, 2, 3, 4
- Left Semi Join: คืนเฉพาะแถวฝั่งซ้ายที่ “มีคู่” ในฝั่งขวา ได้ลูกค้า 2 กับ 3 แต่ได้เฉพาะคอลัมน์ของ orders เท่านั้น ตารางขวาทำหน้าที่เป็นแค่ตัวกรอง และแถวซ้ายแต่ละแถวจะถูกคืนมาอย่างมากแค่ครั้งเดียว ไม่ว่าฝั่งขวาจะมีคู่กี่แถวก็ตาม
- Left Anti Join: ตรงข้ามกับ Semi คืนเฉพาะแถวฝั่งซ้ายที่ “ไม่มีคู่” ได้ลูกค้า 1 ตอบโจทย์แนว “ลูกค้าที่ยังไม่เคยทำรายการ” ได้ตรงๆ โดยไม่ต้อง Left Join แล้วมานั่งเช็ค NULL อีกที
- Cross Join: จับคู่ทุกแถวกับทุกแถว 3 x 3 ได้ 9 แถว ไม่มีเงื่อนไข key เลย
ใน DataFrame API ก็สั่งผ่าน argument ตัวที่สามตรงๆ แบบนี้ได้เลยครับ
orders.join(customers, "customer_id", "inner")orders.join(customers, "customer_id", "left") # หรือ left_outerorders.join(customers, "customer_id", "right") # หรือ right_outerorders.join(customers, "customer_id", "full") # หรือ outer, full_outerorders.join(customers, "customer_id", "left_semi") # หรือ semiorders.join(customers, "customer_id", "left_anti") # หรือ antiorders.crossJoin(customers)
มีเรื่องเล็กๆ ที่คนมักพลาดอยู่หนึ่งเรื่องคือ key ที่เป็น NULL จะไม่ถูกจับคู่กันเอง เพราะตามหลัก SQL แล้ว NULL = NULL ไม่ได้ให้ผลเป็นจริง ถ้าฝั่งซ้ายมี NULL หนึ่งแถว ฝั่งขวามี NULL หนึ่งแถว Inner Join ปกติจะไม่คืนคู่นี้มาให้ ถ้าอยากให้ NULL จับคู่กับ NULL ต้องใช้ null-safe equality อย่าง <=> ใน SQL หรือ eqNullSafe ใน DataFrame ครับ
Join Strategy: Spark ลงมือ join ยังไง
ทีนี้มาถึงส่วนที่ทำให้ job เร็วหรือช้ากันจริงๆ เวลาเรียก .explain() เราจะเห็นชื่อ Operator ใน Physical Plan ซึ่งมีให้เจออยู่ห้าตัวหลักๆ
1. Broadcast Hash Join (BHJ)
BroadcastHashJoin
ไอเดียคือ ถ้าฝั่งหนึ่งเล็กพอ ก็ไม่ต้องไปขยับฝั่งใหญ่เลย Spark จะรวบฝั่งเล็กมาที่ Driver ก่อน แล้วส่งสำเนาไปให้ทุก Executor แต่ละ Executor สร้าง Hash Table จากฝั่งเล็กเก็บไว้ใน memory จากนั้นก็ไล่อ่านฝั่งใหญ่ที่ตัวเองถืออยู่ทีละแถว แล้วไปค้นใน Hash Table ได้ทันที ฝั่งใหญ่จึงไม่ต้อง Shuffle เลยครับ
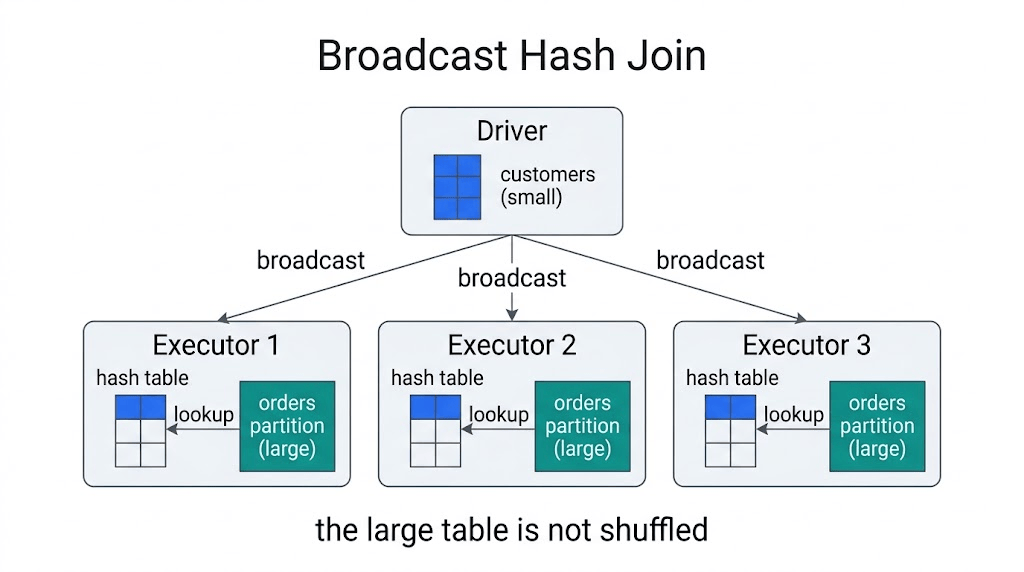
ข้อควรรู้ของ BHJ มีหลายข้อ
- ใช้ได้กับ equi join (เงื่อนไขเท่ากับ) เท่านั้น
- Spark จะเลือก BHJ ให้อัตโนมัติเมื่อประเมินว่าฝั่งนั้นเล็กกว่า
spark.sql.autoBroadcastJoinThresholdซึ่งค่า default คือ 10 MB (ตั้งเป็น -1 เพื่อปิดได้) หรือเราจะสั่งเองด้วย Hint ก็ได้ - Spark ต้อง “รู้” ขนาดของฝั่งเล็กก่อน ซึ่งมาจาก Statistics ของไฟล์หรือตาราง ถ้าไม่มีข้อมูลขนาด เช่น DataFrame ที่สร้างมาจาก RDD Spark จะไม่กล้า Broadcast ให้เอง และเลือกทางที่ปลอดภัยกว่าอย่าง Sort Merge Join ไปก่อน
- ฝั่งที่ต้อง “เก็บแถวไว้ให้ครบ” Broadcast ไม่ได้ เช่น ฝั่งซ้ายของ Left Outer ฝั่งขวาของ Right Outer และ Full Outer Broadcast ไม่ได้เลยทั้งสองฝั่ง เหตุผลคือการจะรู้ว่าแถวไหน “ไม่มีคู่” ต้องเห็นข้อมูลอีกฝั่งทั้งหมด แต่ Executor แต่ละตัวเห็นแค่ฝั่งใหญ่เป็นบางส่วนเท่านั้น (ส่วน Inner, Left ที่ Broadcast ฝั่งขวา, Semi และ Anti ทำได้ปกติ)
- ถ้าใหญ่เกินไปจะเสี่ยง OOM ทั้งที่ Driver และ Executor และถ้า Broadcast ช้าเกิน
spark.sql.broadcastTimeout(default 300 วินาที) งานก็จะล้ม
2. Sort Merge Join (SMJ)
SortMergeJoin
ตัวนี้คือ “ม้างาน” ของการ join ข้อมูลใหญ่ชนข้อมูลใหญ่ และเป็น default ของ equi join เมื่อ Broadcast ไม่ได้ โดยทำงานเป็นสามขั้นตอน
- Shuffle: แบ่งทั้งสองฝั่งด้วย Hash ของ join key เพื่อให้ key เดียวกันไปอยู่ Partition เลขเดียวกัน
- Sort: เรียงข้อมูลในแต่ละ Partition ตาม key
- Merge: ไล่อ่านสองฝั่งที่เรียงแล้วไปพร้อมกันด้วย “ตัวชี้” สองตัว ถ้า key ตรงกันก็จับคู่ ถ้าไม่ตรงก็ขยับฝั่งที่ key น้อยกว่า
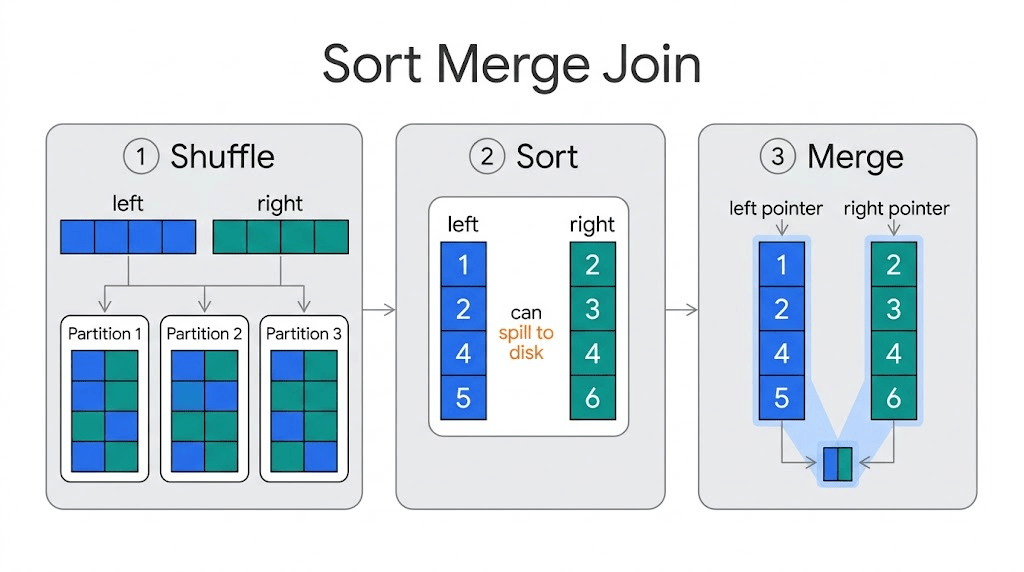
จุดแข็งคือ การ Sort สามารถ spill ลงดิสก์ได้ จึงไม่ต้องเก็บทั้ง Partition ไว้ใน memory ทำให้ทนต่อข้อมูลขนาดใหญ่มากๆ ได้ดี และรองรับทุก Join Type ส่วนจุดอ่อนคือต้อง Shuffle และ Sort ทั้งสองฝั่ง แพงทั้งเครือข่ายและ CPU
ค่า spark.sql.join.preferSortMergeJoin เป็น true โดย default ครับ
3. Shuffled Hash Join (SHJ)
ShuffledHashJoin
ขั้นตอนแรกเหมือน SMJ คือ Shuffle ทั้งสองฝั่งด้วย Hash ของ key แต่ต่างกันตรงที่
ไม่ Sort แล้ว
ในแต่ละ Partition จะเอาฝั่งที่เล็กกว่าไปสร้างเป็น Hash Table แล้วให้ฝั่งที่ใหญ่กว่าวิ่งมาค้น (Build แล้ว Probe) จึงเสียเวลาน้อยกว่า SMJ ตรงที่ไม่ต้อง Sort
- Build: เอาแถวของฝั่งที่เล็กกว่ามาผ่าน Hash Function แล้วสร้างเป็น Hash Table เก็บไว้ใน memory
- Probe: เอาแถวของฝั่งที่ใหญ่กว่ามาค้นทีละแถว โดย Hash key ด้วยวิธีเดียวกันแล้วเปิดดูช่องที่ตรงกันใน Hash Table ถ้าเจอก็จับคู่ออกเป็นผลลัพธ์ทันที
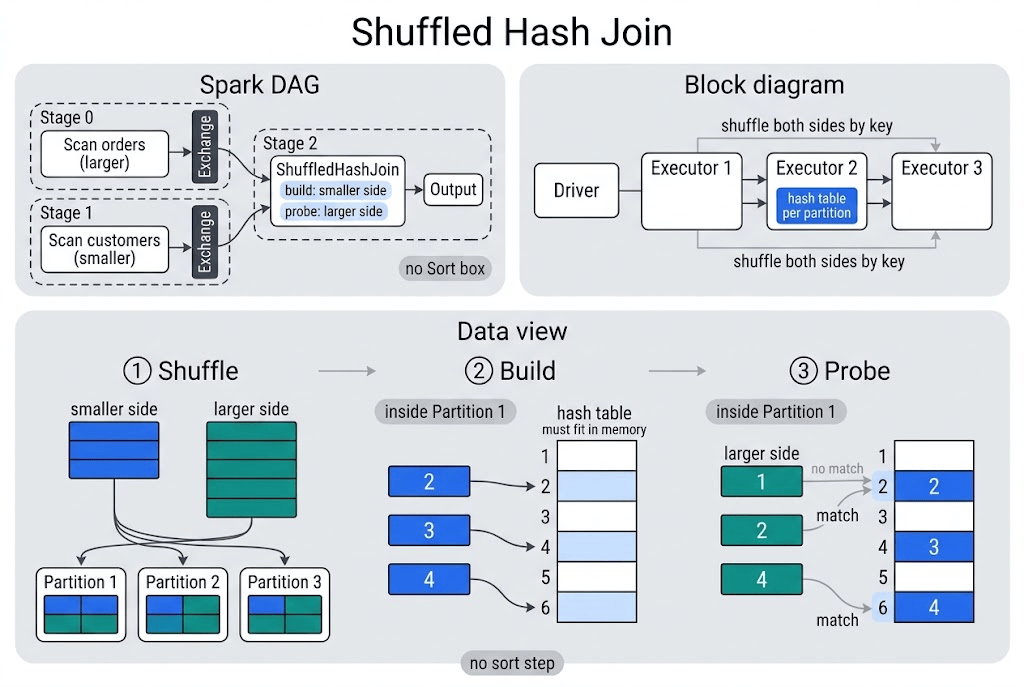
แต่ข้อแลกเปลี่ยนคือ Hash Table ของแต่ละ Partition ต้องอยู่ใน memory ได้ทั้งหมด ถ้า Partition ไหนบวมเกินก็เสี่ยง OOM ในขณะที่ SMJ ยัง spill ลงดิสก์ได้ Spark จึงไม่ค่อยเลือกตัวนี้ให้เองครับ ต้องปิด preferSortMergeJoin หรือใช้ Hint SHUFFLE_HASH และฝั่งเล็กต้องเล็กพอ (และเล็กกว่าอีกฝั่งมากพอ) ด้วย ส่วนเรื่อง Join Type นั้น Spark รุ่นใหม่ๆ รองรับกว้างขึ้นแล้ว รวมถึง Full Outer
4. Broadcast Nested Loop Join (BNLJ)
BroadcastNestedLoopJoin
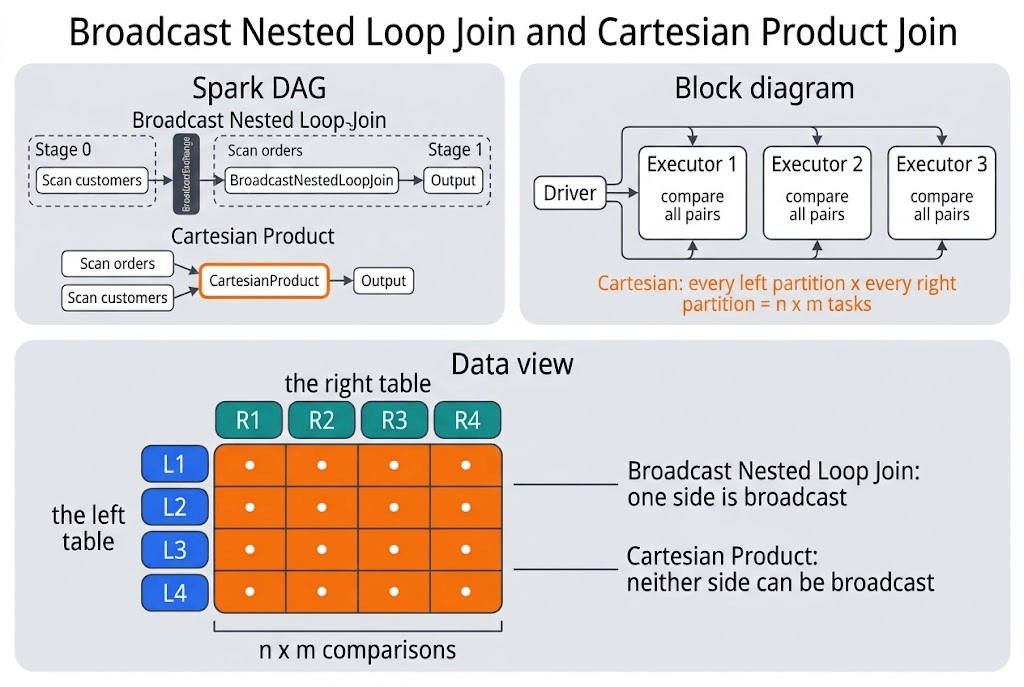
เมื่อเงื่อนไข join ไม่ใช่รูปแบบการเท่ากัน (non-equi join) เช่น a.price > b.min_price หรือ BETWEEN ตามช่วงเวลา จะทำให้ไม่มี key ให้เอาไป Hash หรือ Sort ได้ ทำให้ตัวตระกูล Hash Join และ Sort Merge Join จึงใช้ไม่ได้ทั้งหมด และโดยเฉพาะถ้าเกิดว่าฝั่งหนึ่งเล็กพอจะ Broadcast ได้ (หรือเป็น Outer Join ที่ไม่มี equi key ซึ่งบังคับให้ต้องใช้ท่านี้แม้ข้อมูลอาจจะใหญ่ก็ตาม) Spark จะส่งฝั่งหนึ่งไปที่ทุก Executor แล้ววนลูปเทียบเงื่อนไขกับ “ทุกคู่”
5. Cartesian Product Join
CartesianProduct
ถ้าไม่มี equi key และ Broadcast ก็ไม่ได้ (Inner Join เท่านั้น) ก็เหลือทางเดียวคือจับทุกแถวฝั่งซ้ายคูณทุกแถวฝั่งขวา ข้อมูลฝั่งละล้านแถวก็คือหนึ่งล้านล้านคู่ นี่คือสิ่งที่ควรหลีกเลี่ยงที่สุดในบรรดาทั้งหมดครับ ถ้าต้องการ Cross Join จริงๆ ให้เขียน crossJoin() ให้ชัดเจนเพื่อแสดงเจตนา อย่าปล่อยให้มันเกิดขึ้นโดยบังเอิญจากการลืมใส่เงื่อนไข
ความเหมือนที่แตกต่าง: BHJ vs SMJ vs SHJ
สามตัวแรกคือกลุ่มที่ใช้กับ equi join ซึ่งเจอบ่อยที่สุด ลองเทียบกันตรงๆ ดูครับ
ทวนอีกที
BHJ – Broadcast Hash Join
SMJ – Sort Merge Join
SHJ – Shuffled Hash Join
- เรื่อง Shuffle: BHJ จะไม่ Shuffle ฝั่งใหญ่เลย ส่วน SMJ กับ SHJ ต้อง Shuffle ทั้งสองฝั่ง
- เรื่อง Sort: มีเฉพาะ SMJ ที่ต้อง Sort ข้อมูลทั้งสองฝั่ง
- เรื่อง memory:
– BHJ ต้องแบกฝั่งเล็กทั้งก้อนไว้ในทุก Executor (และต้องผ่าน Driver ก่อน)
– SHJ ต้องเก็บ Hash Table ของแต่ละ Partition
– SMJ มีความทนที่สุดเพราะ spill ลงดิสก์ได้ - เรื่อง Join Type: BHJ Broadcast ได้เฉพาะฝั่งที่ไม่ต้องเก็บแถวไว้ครบ เช่น Left Outer Broadcast ได้แค่ฝั่งขวา, Right Outer Broadcast ได้แค่ฝั่งซ้าย ส่วน Full Outer Broadcast ไม่ได้เลย เพราะ Executor แต่ละตัวเห็นฝั่งใหญ่แค่บางส่วน จึงบอกไม่ได้ว่าแถวที่ต้องเก็บไว้ครบนั้น “ไม่มีคู่จริงๆ” หรือแค่คู่ไปอยู่ที่ Executor ตัวอื่น ในขณะที่ SMJ Shuffle ทั้งสองฝั่งด้วย key ทำให้แถวที่ key เดียวกันมาอยู่ Partition เดียวกันเสมอ จึงตัดสินได้เองและใช้ได้ครบทุกแบบ
- เรื่องขนาดข้อมูลที่เหมาะ: BHJ เหมาะเมื่อมีฝั่งเล็ก SMJ เหมาะเมื่อใหญ่ชนใหญ่ SHJ เหมาะเมื่อมีฝั่งที่เล็กกว่ามากแต่ใหญ่เกินจะ Broadcast
Spark เลือก Strategy ให้เรายังไง
สำหรับ equi join Spark จะไล่ดูตัวเลือกโดยประมาณตามลำดับนี้ครับ Broadcast Hash Join ก่อน ถ้าไม่ได้ก็ Sort Merge Join แล้วค่อย Shuffled Hash Join ส่วนกรณีไม่มี equi key ก็จะไปที่ Broadcast Nested Loop Join หรือ Cartesian Product
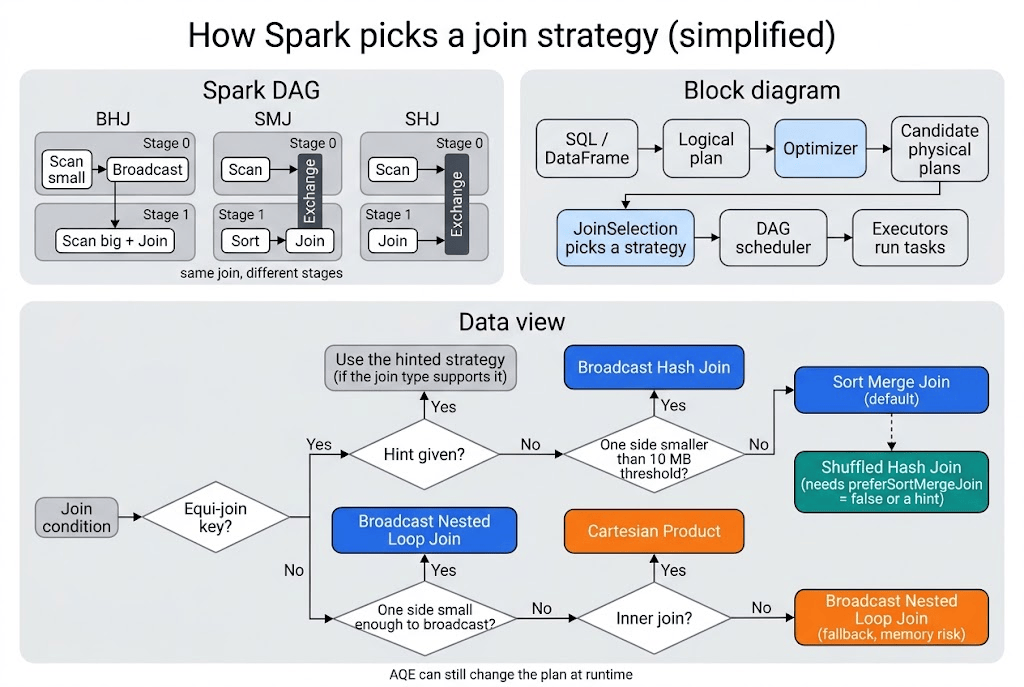
ถ้าเรารู้ข้อมูลดีกว่า Spark ก็สามารถบอกใบ้ผ่าน Hint ได้ มีให้ใช้สี่แบบคือ BROADCAST, MERGE, SHUFFLE_HASH และ SHUFFLE_REPLICATE_NL
from pyspark.sql.functions import broadcastorders.join(broadcast(customers), "customer_id") # Broadcast Hash Joinorders.join(customers.hint("merge"), "customer_id") # Sort Merge Joinorders.join(customers.hint("shuffle_hash"), "customer_id") # Shuffled Hash Join
SELECT /*+ BROADCAST(c) */ *FROM orders oJOIN customers c ON o.customer_id = c.customer_id
ถ้ามี Hint ขัดกันสองฝั่ง Spark จะให้ความสำคัญตามลำดับ BROADCAST ก่อน MERGE ก่อน SHUFFLE_HASH ก่อน SHUFFLE_REPLICATE_NL
แต่ช้าก่อน! Hint คือ “คำขอ” ไม่ใช่ “คำสั่ง” ครับ ถ้า Strategy ที่ขอไม่รองรับ Join Type นั้น Spark ก็จะเมินแล้วเลือกตัวอื่นแทน เช่น สั่ง Broadcast ใส่ Full Outer Join ก็จะได้ Sort Merge Join กลับมาอยู่ดี
พออ่านได้แล้วว่าทางเลือกมีอะไรบ้าง เวลาเจอสถานการณ์จริงก็ลองคิดแบบนี้
- ตารางเล็กอย่าง Dimension join กับตารางใหญ่อย่าง Fact: เล็งไปที่ Broadcast ก่อนเลย
- ใหญ่ชนใหญ่ด้วย equi key: ปล่อย Sort Merge Join เป็น default ไปครับ แล้วไปโฟกัสที่ปัญหา Skew แทน
- ไม่มี equi key: ลองกลับไปคิดว่าแปลงให้มี equi key ได้ไหม เช่น แบ่งช่วงเวลาเป็น bucket แล้ว join ด้วย bucket ก่อนค่อยกรองเงื่อนไขละเอียดทีหลัง
- ต้องการแค่ “มีหรือไม่มี”: ใช้ Semi หรือ Anti แทนการ Inner แล้ว Distinct ซึ่งทั้งสั้นกว่าและ Spark ทำงานให้ได้ตรงจุดกว่า
Data Skew: ศัตรูตัวฉกาจของ Join
ต่อให้เลือก Strategy ถูกแล้ว ก็ยังมีปัญหาหนึ่งที่ทำให้ job ช้าได้อีก นั่นคือ Data Skew ครับ
เนื่องจาก Shuffle แบ่งข้อมูลด้วย Hash ของ key ดังนั้น key เดียวกันจะตกไปอยู่ Partition เดียวกันเสมอ ถ้า key ใด key หนึ่งมีแถวเยอะผิดปกติ Partition นั้นก็จะบวมตามไปด้วย Task ที่ดูแล Partition นั้นก็จะทำงานนานกว่าตัวอื่นๆ มาก ในขณะที่ตัวอื่นเสร็จไปหมดแล้วและต้องนั่งรอ ทั้ง Stage จึงช้าเท่ากับ Task ที่ช้าที่สุด และบางครั้งก็ล้มด้วย OOM เลย
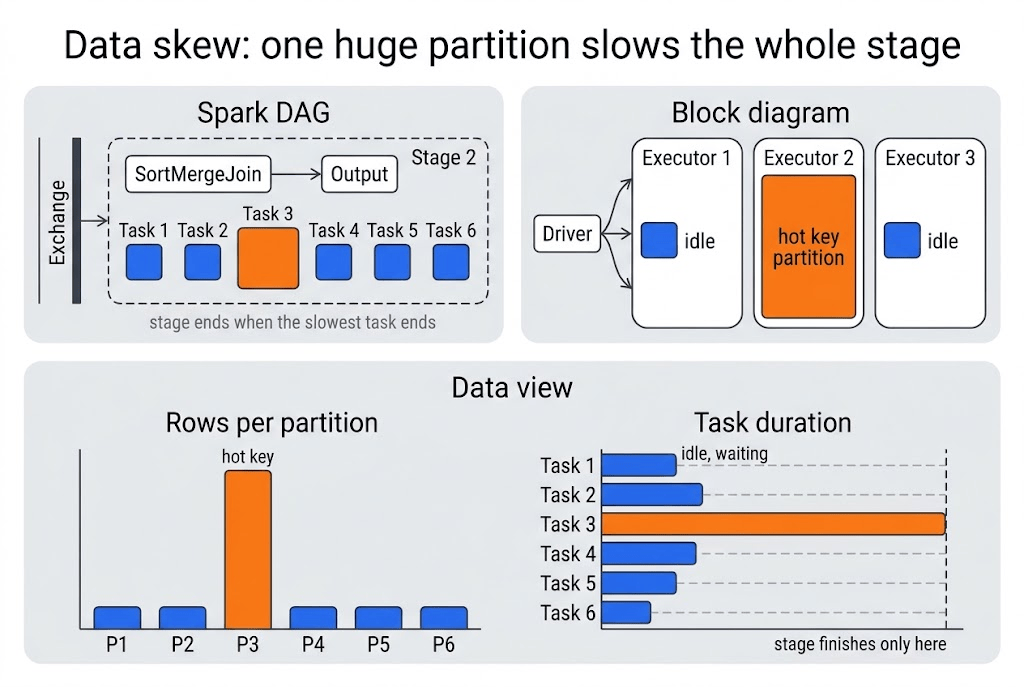
ต้นตอที่เจอบ่อยคือ
- ค่า NULL จำนวนมาก
- ค่า default อย่าง -1, 0 หรือ “unknown” ที่ถูกใส่แทนข้อมูลที่ขาดหายไป
- เจ้าของ key ที่ใหญ่ผิดธรรมดา เช่น ลูกค้ารายใหญ่ หรือ Entity ที่ได้รับความนิยมสูงมาก
วิธีรับมือมีหลายระดับ เรียงจากง่ายไปยาก
- ปล่อยให้ AQE จัดการ (เอาไว้เดี๋ยวเล่าในหัวข้อถัดไป)
- ถ้าอีกฝั่งเล็กพอ ก็ Broadcast ไปเลย จะได้ไม่ต้อง Shuffle ทำให้ Skew ไม่มีผล
- กรอง NULL key ทิ้งก่อน ถ้า Join Type ที่ใช้อยู่ไม่มีทางจับคู่กับ NULL อยู่แล้ว (เช่น Inner Join) ลดข้อมูลที่จะถูก Shuffle ไปได้ทันที
- แยกจัดการ Hot Key ต่างหาก เช่น Hot Key ไม่กี่ตัวให้ join แบบ Broadcast แล้ว key ที่เหลือก็ join ปกติ จากนั้นค่อย Union ผลลัพธ์รวมกัน
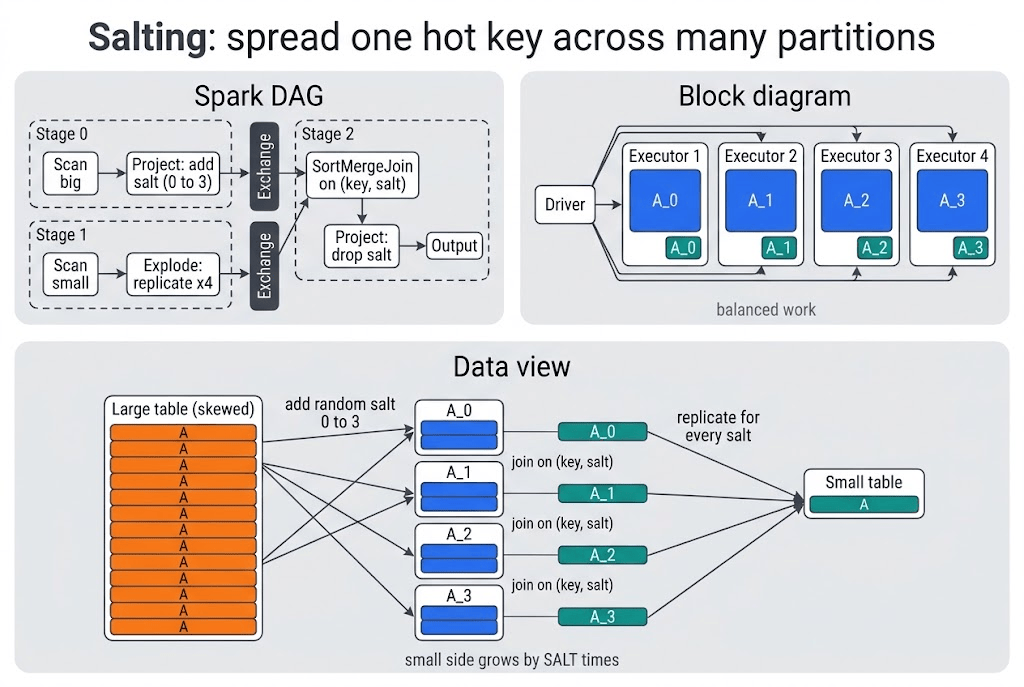
- Salting คือการเติมเลขสุ่มต่อท้าย key ของฝั่งที่ Skew เพื่อกระจายแถวของ key เดียวกันไปหลาย Partition แล้ว replicate อีกฝั่งให้ครบทุกค่าของเลขสุ่มนั้น
หน้าตาของ Salting ประมาณนี้ครับ (ตัวอย่างเพื่อประกอบความเข้าใจ)
from pyspark.sql import functions as FSALT = 8# ฝั่งใหญ่ที่ Skew: สุ่มเลข salt ให้แต่ละแถว เพื่อกระจาย key เดียวกันไปหลาย Partitionbig_salted = big.withColumn("salt", (F.rand() * SALT).cast("int"))# ฝั่งเล็ก: replicate ทุกแถวให้ครบทุกค่าของ saltsmall_salted = small.withColumn( "salt", F.explode(F.array(*[F.lit(i) for i in range(SALT)])))result = big_salted.join(small_salted, ["key", "salt"]).drop("salt")
ข้อแลกเปลี่ยนก็คือฝั่งเล็กจะบวมขึ้นตาม SALT และโค้ดซับซ้อนขึ้น จึงควรเก็บไว้ใช้เมื่อวิธีอื่นไม่พอเท่านั้นครับ
AQE: ให้ Spark ปรับแผนตอนรัน
Adaptive Query Execution (AQE)
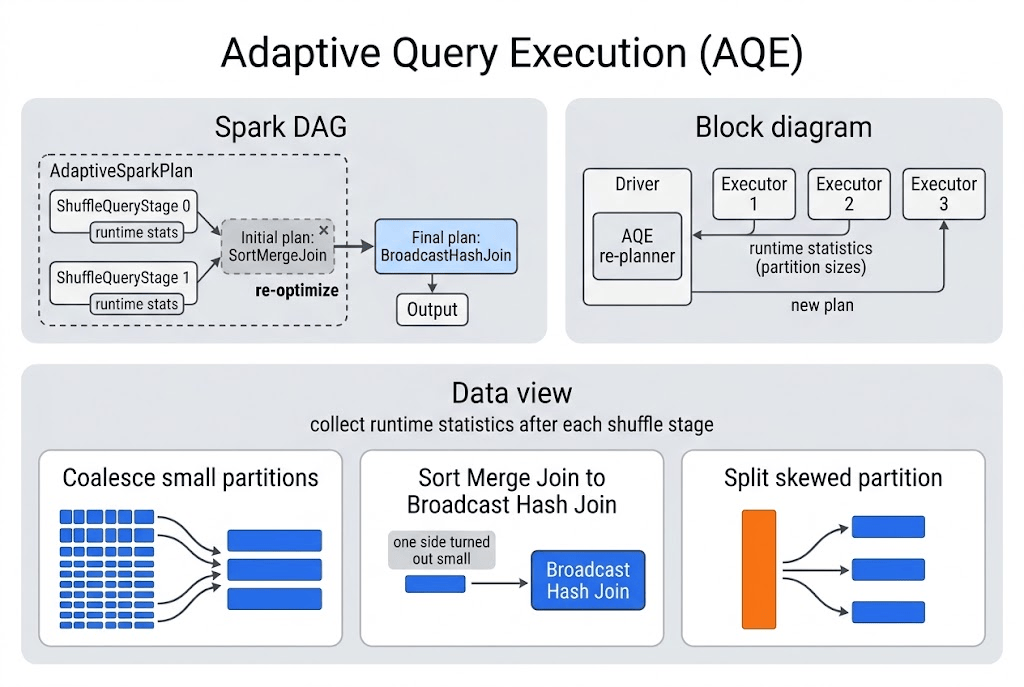
ปกติ Spark วางแผนก่อนรันโดยอาศัยการประเมินขนาดข้อมูล ซึ่งถ้าประเมินพลาดแผนก็พลาดตาม AQE จึงเข้ามาแก้ตรงนี้ โดยใช้สถิติจริงที่ได้หลังแต่ละ Shuffle Stage จบ แล้วปรับแผนส่วนที่เหลือใหม่ระหว่างทาง เปิดใช้งานเป็น default มาตั้งแต่ Spark 3.2 แล้ว และมีสามความสามารถหลักที่เกี่ยวกับ join ครับ
- Coalesce Shuffle Partitions: รวม Partition เล็กๆ หลังการ Shuffle ให้มีขนาดพอเหมาะ (ขนาดเป้าหมายคือ
spark.sql.adaptive.advisoryPartitionSizeInBytesdefault 64 MB) ช่วยแก้เรื่องspark.sql.shuffle.partitionsที่ default ไว้ 200 ซึ่งมักไม่พอดีกับข้อมูลจริง - แปลง Sort Merge Join เป็น Broadcast Hash Join: ถ้าตอนรันจริงพบว่าฝั่งหนึ่งเล็กกว่าที่ประเมินไว้ (เช่น หลังผ่าน Filter ไปแล้ว) AQE จะสลับไปใช้ BHJ ให้เอง ประหยัดการ Sort ทั้งสองฝั่ง นอกจากนี้ยังสามารถแปลงเป็น Shuffled Hash Join ได้เมื่อทุก Partition หลัง Shuffle มีขนาดเล็กพอ
- Skew Join Optimization: ตรวจจับ Partition ที่ใหญ่ผิดปกติแล้วแตกออกเป็นชิ้นย่อยๆ (และ replicate ข้อมูลฝั่งตรงข้ามถ้าจำเป็น) โดย Partition จะถูกมองว่า Skew เมื่อใหญ่กว่าค่ามัธยฐานคูณ
skewedPartitionFactor(default 5) และใหญ่กว่าskewedPartitionThresholdInBytes(default 256 MB) ทั้งสองเงื่อนไข และมีข้อจำกัดว่าบาง Join Type ก็ช่วยได้ฝั่งเดียว เช่น Left Outer จะเพิ่มประสิทธิภาพได้เฉพาะ Skew ฝั่งซ้าย
spark.conf.set("spark.sql.adaptive.enabled", "true") # เปิดอยู่แล้วโดย defaultspark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true") # เปิดอยู่แล้วโดย default
ถ้าอยากดูว่า AQE ทำอะไรไปบ้าง ให้ลองเรียก .explain() ดูครับ จะเห็น Node ชื่อ AdaptiveSparkPlan พร้อมแฟลก isFinalPlan ที่เป็น false ก่อนรัน และกลายเป็น true หลังรันเสร็จ
อย่างไรก็ดี เอกสารของ Spark เองก็บอกไว้ว่า การที่ AQE สลับมาเป็น Broadcast ตอนรันนั้นไม่ได้มีประสิทธิภาพเท่ากับการวางแผน Broadcast ตั้งแต่แรก (เพราะ Shuffle ฝั่งใหญ่ไปแล้วส่วนหนึ่ง) ดังนั้นถ้าเรารู้แน่ว่าฝั่งไหนเล็ก การใส่ Hint ก็ยังมีประโยชน์อยู่ครับ
ลดต้นทุนก่อนจะ Join
ก่อนไปปรับจูนที่ Strategy ลองดูสิ่งที่ทำได้ตั้งแต่ก่อน join ซึ่งมักได้ผลมากกว่าด้วยซ้ำ
- Filter และ Select เฉพาะคอลัมน์ที่ต้องใช้ให้เร็วที่สุด ข้อมูลที่ต้อง Shuffle ลดลงโดยตรงเลย
- Aggregate ล่วงหน้า ถ้าอีกฝั่งมีหลายแถวต่อ key แต่เราต้องการแค่ค่าสรุป ให้ GROUP BY ให้เสร็จก่อนค่อย join
- ให้ชนิดข้อมูลของ join key สองฝั่งตรงกัน จะได้ไม่เกิดการ Cast โดยไม่ตั้งใจ
- ใช้ Bucketing (เสริมด้านล่าง) กับตารางใหญ่ที่ join กันบ่อยๆ ด้วย key เดียวกัน เมื่อสองตารางถูกแบ่ง Bucket ด้วย key และจำนวน Bucket ที่สอดคล้องกัน Spark อ่านไฟล์ Bucket ที่คู่กันมา join ได้เลยโดยข้ามการ Shuffle แต่ต้องวางแผนตั้งแต่ตอนเขียนข้อมูล
- ปรับ
spark.sql.shuffle.partitionsให้เหมาะกับขนาดข้อมูล หรือเปิดให้ AQE ช่วย Coalesce - อ่าน Query Plan ด้วย
.explain()ก่อนเสมอ เพราะมันบอกชัดๆ ว่า Spark เลือกอะไรไปแล้ว
อีกมุมหนึ่งที่ฝั่ง Orchestrator ควรตระหนักคือ ถ้า pipeline ถูกสั่งงานโดย Airflow แล้ว job ไหนช้าเพราะ Skew หรือเลือก Strategy ผิด มันก็ไม่ได้ลากแค่ตัวเอง แต่ลากทั้ง DAG ที่ต่อท้ายให้ช้าตามไปด้วยครับ
เสริม Bucketing: จ่ายค่า Shuffle ล่วงหน้าตั้งแต่ตอนเขียนข้อมูล
Bucketing
Bucket แปลตรงๆ คือ “ถัง” ครับ Bucketing คือการแบ่งข้อมูลของตารางออกเป็นถังตั้งแต่ตอนเขียนลงดิสก์ โดยเราเลือกคอลัมน์ที่ใช้แบ่ง (เช่น customer_id) กับจำนวนถัง (เช่น 8) จากนั้น Spark จะเอา key ของแต่ละแถวไปผ่าน Hash Function แล้วหารเอาเศษด้วยจำนวนถัง เพื่อดูว่าแถวนี้ต้องตกถังไหน แล้วเขียนลงไฟล์ของถังนั้น ผลคือแถวที่ key เดียวกันจะอยู่ถังเดียวกันเสมอ
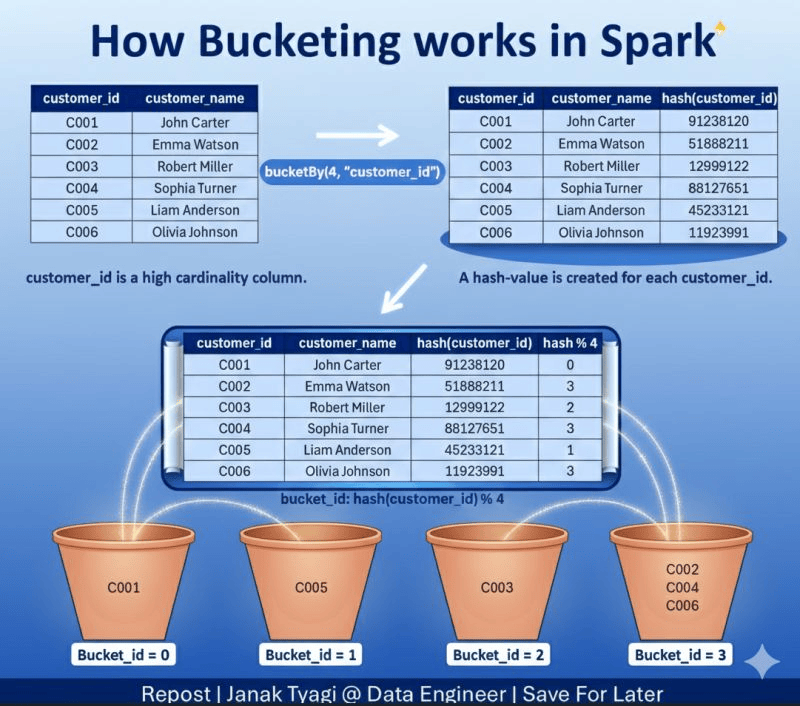
ถ้ายังจำ Shuffle ที่แบ่ง Partition ด้วย Hash ของ key ได้ นี่คือหลักการเดียวกันเลยครับ ต่างกันตรงที่ Shuffle ทำตอนรันและต้องทำใหม่ทุกครั้งที่ join ส่วน Bucketing ทำครั้งเดียวตอนเขียน เหมือนจ่ายราคาของ Shuffle ล่วงหน้าไปก่อน แล้ว join รอบหลังๆ ก็ไม่ต้องจ่ายอีก
orders.write.bucketBy(8, "customer_id").sortBy("customer_id").saveAsTable("orders_b")customers.write.bucketBy(8, "customer_id").sortBy("customer_id").saveAsTable("customers_b")spark.table("orders_b").join(spark.table("customers_b"), "customer_id")
สังเกตว่าต้องเขียนด้วย saveAsTable เพราะ Spark ต้องจำข้อมูล Bucket ของตารางไว้ใน Catalog ครับ
เมื่อสองตารางถูก Bucket ด้วย key เดียวกันและจำนวนถังเท่ากัน Spark รู้ทันทีว่าถังที่ 3 ของ orders จะมี key ชุดเดียวกับถังที่ 3 ของ customers เท่านั้น จึงอ่านถังที่คู่กันมา join กันได้เลย พอเรียก .explain() ก็จะไม่เห็น Exchange อีกต่อไป (ขั้น Sort อาจยังเหลืออยู่ โดยเฉพาะเมื่อแต่ละถังถูกเขียนเป็นหลายไฟล์ แต่ Exchange คือส่วนที่แพงที่สุดครับ)
ข้อควรรู้ก่อนใช้
- ต้อง join ด้วยคอลัมน์ที่ใช้ Bucket เท่านั้น
- จำนวนถังควรเท่ากัน ถ้าไม่เท่ากัน Spark จะ Shuffle อีกฝั่งอยู่ดี (ถังใหญ่หารด้วยถังเล็กลงตัวและเปิด
spark.sql.bucketing.coalesceBucketsInJoin.enabledก็ยังข้าม Shuffle ได้ แต่ค่า default ปิดอยู่) - ถ้าอีกฝั่งไม่ได้ Bucket Spark จะ Shuffle แค่ฝั่งนั้น ฝั่งที่ Bucket ไว้ไม่ต้องขยับ
- ต้องวางแผนล่วงหน้า ถ้าอยากเปลี่ยน key หรือจำนวนถังทีหลัง ต้องเขียนข้อมูลใหม่ทั้งตาราง
- ไฟล์เล็กๆ จะเยอะขึ้น เพราะแต่ละ Task ที่เขียนอาจสร้างไฟล์ได้ถึงจำนวนถัง เช่น 2 Task กับ 8 ถังได้ถึง 16 ไฟล์ แทนที่จะเป็น 2 ไฟล์
- Data Skew ไม่ได้หายไป key ที่ร้อนก็ยังตกถังเดียวกันอยู่ดี
ดังนั้น Bucketing เหมาะกับตารางใหญ่ที่ถูก join ด้วย key เดิมซ้ำๆ เพราะจ่ายครั้งเดียวแล้วคุ้มหลายรอบ แต่ถ้า join ครั้งเดียวจบ ไม่ค่อยคุ้มครับ
ทั้งหมดจึงขอสรุปประมาณนี้ว่า
Join Type คือสิ่งที่เราต้องการ ส่วน Join Strategy คือวิธีที่ Spark ใช้ทำให้ได้สิ่งนั้น
สองอย่างนี้แยกกันคิดได้
ถ้าทำงานกับตารางเล็กอย่าง Dimension ที่ต้อง join กับตารางใหญ่อย่าง Fact Broadcast Hash Join คือตัวเลือกแรกที่ควรนึกถึง
แต่ถ้าเป็นการ join ใหญ่ชนใหญ่ Sort Merge Join ที่เป็น default ก็ถูกต้องแล้วครับ
สิ่งที่ควรเฝ้าระวังกว่าการเปลี่ยน Strategy คือ Data Skew และถ้าแค่ต้องการเช็คว่า
“มีหรือไม่มี” อย่าลืมว่า Semi กับ Anti Join นั้นตรงจุดกว่าการ Inner Join แล้วค่อย Distinct ครับ
ส่วนเรื่อง Hint ผมมองว่า ไม่ค่อยแนะนำให้ใส่ในทุก query ถ้ายังไม่ได้ดู Query Plan และยังไม่รู้ขนาดข้อมูลจริง เพราะ Hint ที่ผิดจังหวะ (เช่น Broadcast ฝั่งที่โตขึ้นเรื่อยๆ ตามเวลา) วันนี้ที่ข้อมูลยังน้อยอาจเร็วดี แต่สักวันมันจะกลายเป็นระเบิดเวลา OOM ได้ ในยุคที่ AQE เปิดอยู่เป็น default ปล่อยให้ Spark ตัดสินใจก่อน แล้วใช้ Hint เฉพาะจุดที่เรามั่นใจจริงๆ จะปลอดภัยกว่ามาก และสุดท้าย Cartesian Product คือสิ่งที่ต้องระวังที่สุด ถ้าเห็นมันโผล่ใน Plan โดยที่เราไม่ได้ตั้งใจ ให้กลับไปตรวจเงื่อนไข join ทันทีเลยครับ
เอาละ ประมาณนี้ก่อน ใครที่เพิ่งเริ่มสาย Data Engineering ลองเริ่มจากนิสัยง่ายๆ ที่สุดอย่างการเรียก .explain() ดู Plan ทุกครั้งที่เขียน join ใหม่ ก็จะเห็นภาพชัดขึ้นเยอะเลยครับ
เอาไว้คราวหน้าค่อยเจาะลึกกันไปทีละอันกันดีกว่า แบบจับมือทำไปเลย🫡
ref:
https://www.youtube.com/watch?v=g23GHqJje40
https://spark.apache.org/docs/latest/sql-ref-syntax-qry-select-join
https://apache.googlesource.com/spark/+/master/docs/sql-performance-tuning.md
https://docs.databricks.com/optimizations/aqe.html


Leave a Reply